Изменение методологии оценки LLM на artificialanalysis.ai
D@dealerAIAI-инженер
1 месАнализ влияния обновления методологии 4.2 на показатели моделей GPT-6 (Astra) и GPT-5.6 (Sol) на платформе artificialanalysis.ai.
Внешние рейтинги нейросетей могут быстро терять актуальность из-за смены методологий оценки.
- Обновление методологии оценки может существенно изменить расстановку сил между моделями.
- Бенчмарки дают лишь предварительное представление о возможностях ИИ.
- Для выбора модели в реальный бизнес-проект необходимо проводить тестирование на собственных данных.
Это очень интересно.
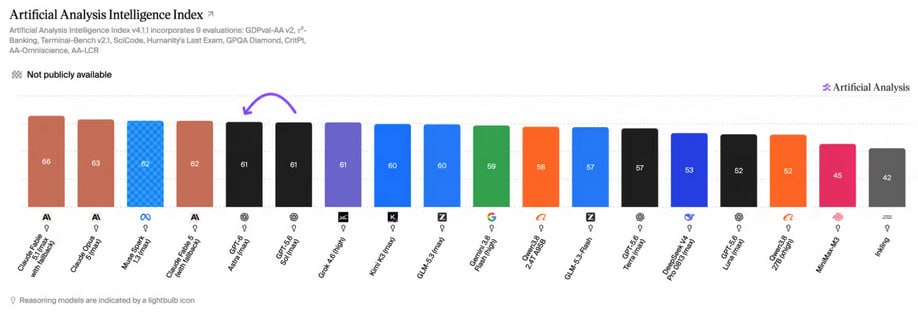
На следующий день после бенчмаркинга GPT-6 (Astra) один из ведущих провайдеров мета бенчмарков artificialanalysis.ai изменил методологию оценки возможностей моделей.
По версии методологии 4.1 GPT-6 (Astra) соответствовала в среднем по своим возможностям GPT-5.6 (Sol) в режиме усилий max. У обоих моделей было по 61 баллу.
В версии методологии 4.2 GPT-6 (Astra) по своим возможностям набрала 55 баллов, а GPT-5.6 (Sol) - 51 балл. В новой версии методологии Astra отстает только от Fable 5.1 по возможностям.
Между версиями методологии оценки возможностей 4.1 и 4.2 - прошло меньше месяца.
Вывод не изменился - итоги внешних бенчмарков для составления короткого списка на реальный тест, в прод только после реального теста на вашем окружении и с вашими данными.
Кратко (AI)
Платформа artificialanalysis.ai обновила методологию оценки нейросетей с версии 4.1 до 4.2, что привело к пересмотру баллов для моделей GPT-6 (Astra) и GPT-5.6 (Sol). Автор подчеркивает, что внешние бенчмарки не являются окончательным критерием выбора модели для продакшена и требуют обязательного тестирования на собственных данных.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖