Результаты независимых тестов GPT-6 Astra
F@FuturisAI-инженер
1 месАнализ производительности модели GPT-6 Astra в тестах Artificial Analysis: сравнение с GPT-5.6 Sol и Fable 5.1 по эффективности и стоимости.
Новые модели ИИ показывают лишь эволюционный, а не революционный рост производительности.
- Специализированные навыки (кодинг) растут быстрее, чем общий интеллект моделей.
- Высокая стоимость API делает использование новых моделей экономически невыгодным для ряда задач.
- Результаты тестов помогают компаниям выбирать инструменты, исходя из реальной эффективности, а не маркетинговых обещаний.
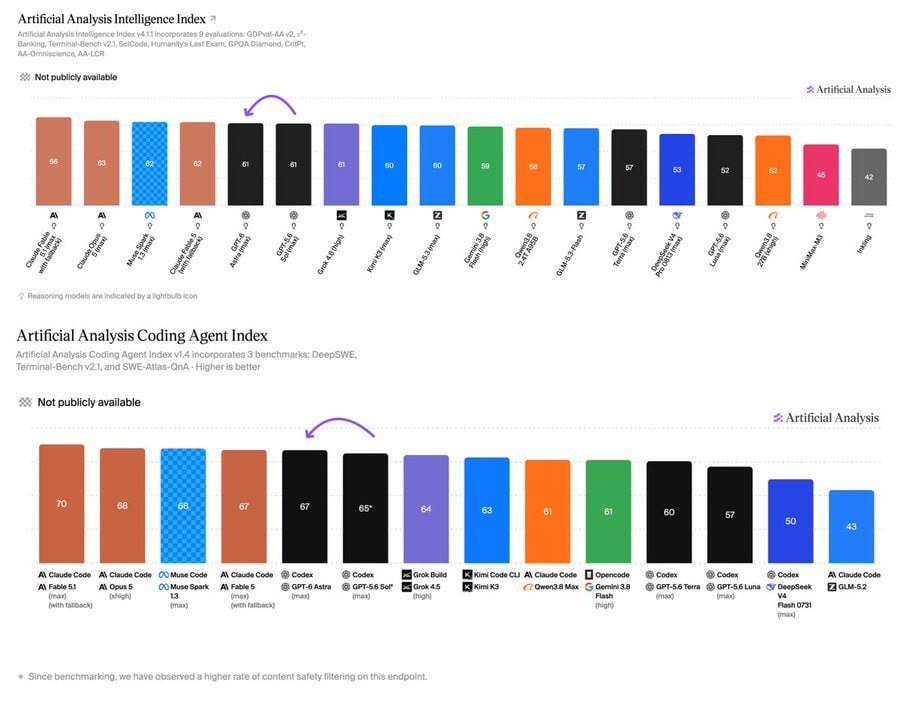
Независимые тесты Artificial Analysis немного охладили хайп вокруг GPT-6 Astra. Astra получила 61 балл, ровно столько же, сколько GPT-5.6 Sol, и уступила Fable 5.1 с результатом 66.
В Coding Agent Index модель набрала 67 баллов. Это уровень Fable 5, но ниже Fable 5.1 с 70 баллами. Зато Astra использует примерно втрое меньше токенов, чем Sol, и при кодинге оказывается выгоднее Fable. В обычных интеллектуальных задачах всё наоборот. Из-за высокой цены API одна задача на Astra обходится примерно на 75% дороже Sol.
Получается, Astra действительно стала намного эффективнее как компьютерный и кодовый агент, но независимые тесты пока не подтверждают революционный скачок в общем интеллекте
https://x.com/ArtificialAnlys/status/2095595489031000350
Разве это AGI?🤔
Кратко (AI)
Независимые тесты от Artificial Analysis показывают, что модель GPT-6 Astra демонстрирует результаты, сопоставимые с GPT-5.6 Sol, и уступает Fable 5.1 в общих тестах. Несмотря на высокую эффективность в написании кода, модель оказалась значительно дороже в использовании для общих задач, что ставит под сомнение заявления о революционном скачке в интеллекте.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖