FocusGUI
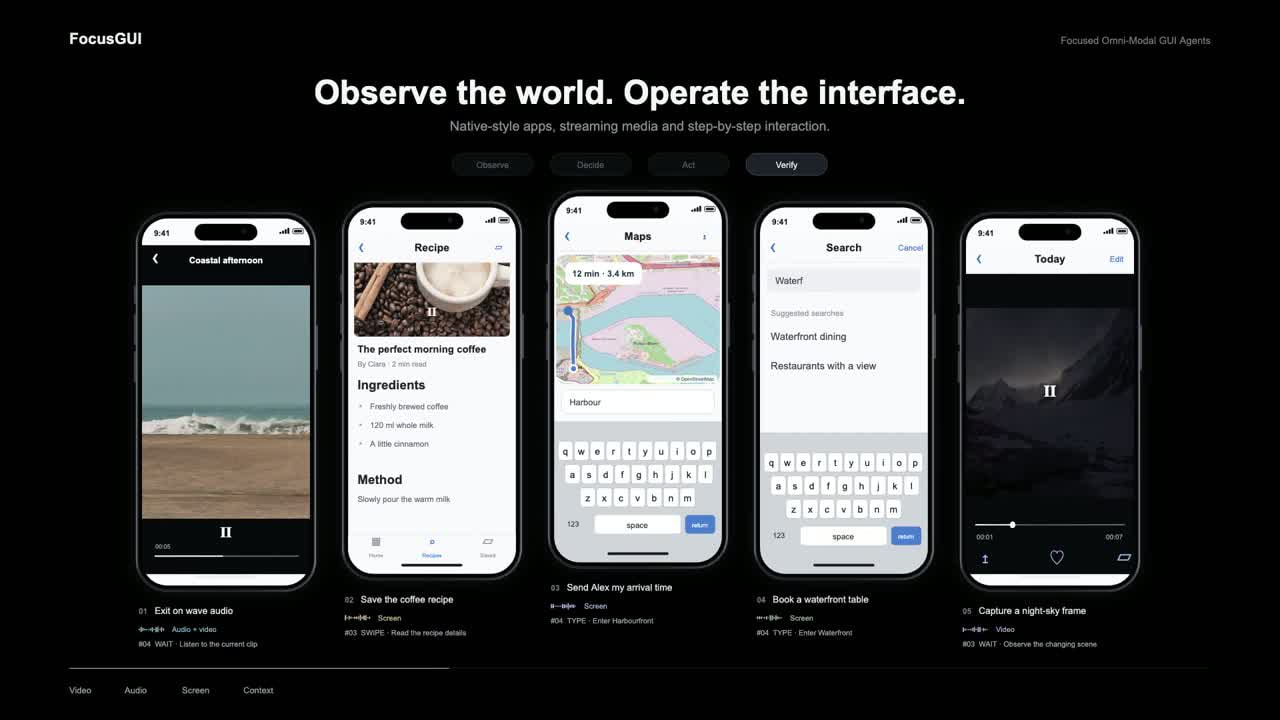
Легкий адаптер для омнимодальных GUI-агентов. Держит внимание на том, что решает текущий шаг, и не дает траектории уехать в сторону.
• Семь каналов: текст с историей, экран, звук, видео, состояние взаимодействия, скрытые признаки, пространственные признаки экрана
• Вес каналов пересчитывается на каждом шаге под текущее решение
• Все нужное сжимается в латент на 64 числа и подмешивается в эмбеддинги декодера
• Базовая модель заморожена, обучается только адаптер
• Обучение по следующему действию, разметка релевантности не нужна
fyzhang1.github.io/FocusGUI
#computeruse #agent
MAX
NVIDIA представила мультимодальную Nemotron 3.5 Super VL с 120 млрд параметров для постоянно работающих агентов. Она обрабатывает текст, изображения и видео, распознаёт документы и выполняет многошаговые задачи с вызовом инструментов.
Одновременно вышли компактные версии для локального запуска: Nemotron 3.5 Bolt 74B-A9B помещается в 24 ГБ видеопамяти, а Bolt E4B рассчитана на устройства с 4 ГБ. Это расширяет варианты применения моделей — от рабочих процессов на компьютере до голосовых помощников и роботов.
TypeSafe обновила модель для принятия решений Jev до версии 1.14: теперь она принимает изображения, может находить на них объекты и обрабатывать длинный контекст. Новые возможности экспериментальные, и TypeSafe пока не рекомендует использовать их в продакшене из-за нестабильного качества.
Обновление расширяет Jev на задачи со скриншотами и фотографиями без предварительного преобразования изображений в текст. Цена не изменилась; версия уже доступна, а перевод основного алиасiа на неё запланирован на 21 октября.
64 тысячтокенов по умолчанию
262 тысячтокенов в длинном режиме
$0,042 за миллион входных токеновтариф без платы за выход
Liquid AI открыла веса двух моделей нового типа — d1-3B и d1-omni-600M, которые не генерируют текст, а за один прямой проход выдают готовое решение: выбор варианта, оценку или вероятность «да/нет». Это избавляет от необходимости генерировать ответ и парсить JSON при маршрутизации запросов, модерации контента, классификации и проверке действий AI-агентов.
Обе модели мультимодальны: d1-3B работает с текстом и изображениями, d1-omni-600M — с текстом в сочетании с изображениями или аудио и пока считается экспериментальной. Главное преимущество — экстремально низкая задержка ответа за счёт отсутствия генерации токенов.
AREX-2
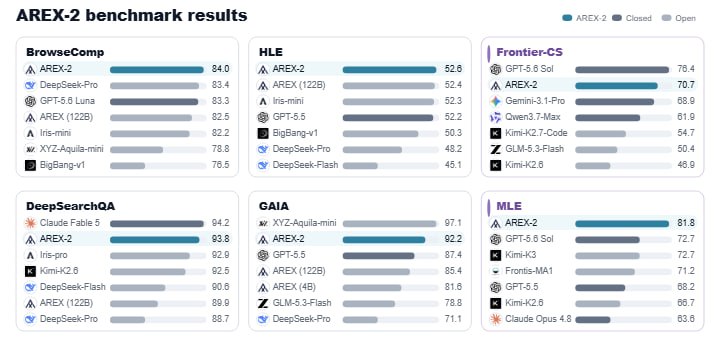
Агентная мультимодальная модель на 27B от BAAI. Самоулучшение через несколько раундов на тесте: propose → measure → reflect → revise
• Улучшает решение по ходу работы рефлексией и правками
• Кодинг, ML-инженерия, глубокий ресерч
• Поведение из кодинга переносится на deep research без доп. поисковых треков
• Мультимодальная, совместима с Qwen3.8
• 27B параметров, плотная модель
• Контекст 262K
гитхаб
#agent #multimodal
MAX
🚀 LongCat-2.5-Preview: 1.6 трлн параметров и контекст на 1 млн токенов
Вышла LongCat-2.5-Preview - новая мультимодальная модель, заточенная под длинные агентные задачи.
Главное:
- 1.6T параметров
- около 48B активных параметров
- контекст до 1 млн токенов
- нативная мультимодальность
- фокус на long-horizon tasks
Модель рассчитана не только на чат, но и на работу через:
- терминал;
- браузер;
- GUI;
- таблицы;
- инструменты для дизайна.
API: https://longcat.ai/platform/
Chat: https://longcat.ai/chat/