MJev-Spatial: decision-модель для пространственных вопросов
Н@GreenNeuralRobotsAI-инженер
1 недMJev-Spatial на базе Qwen3.5-4B выбирает ответ из набора кандидатов, лидирует на 7 из 12 бенчмарков и работает в 5,6 раза быстрее базовой модели.
MJev-Spatial
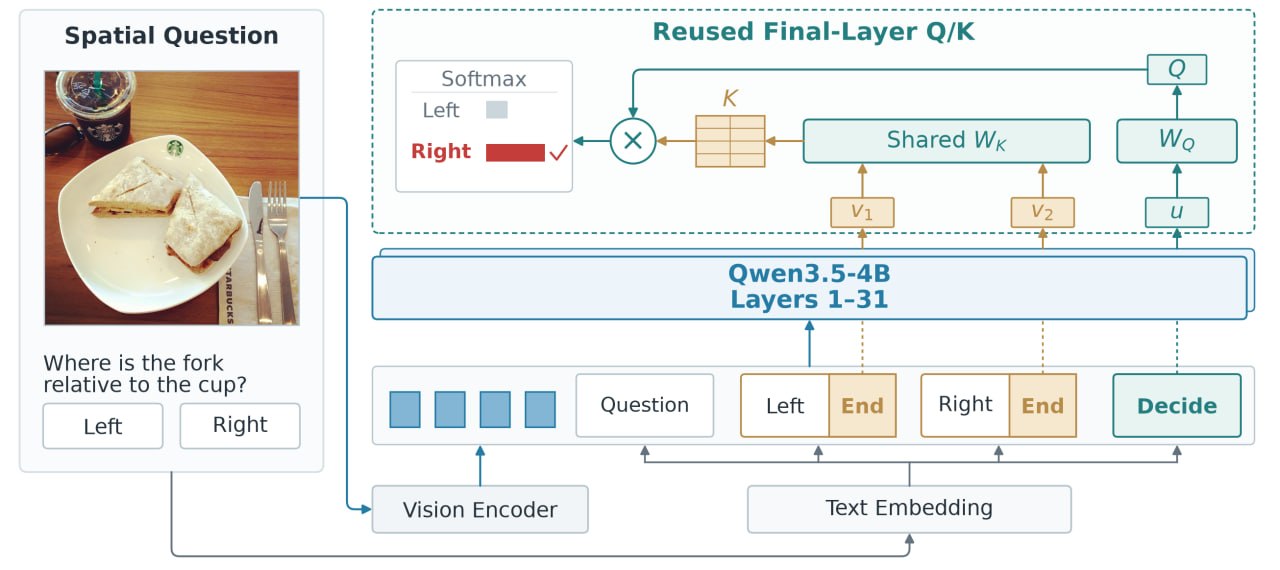
Мультимодальная decision-модель для пространственных вопросов. Превращает вопрос в выбор из конечного набора кандидатов и отвечает классификацией — без генерации токенов ответа.
• База — Qwen3.5-4B, переиспользуются ее же Q/K-проекции для оценки кандидатов
• Лучший средний результат на 7 из 12 бенчмарков
• В 5.6 раза быстрее базовой модели
github.com/Fr0zenCrane/MJev-Spatial
———
Jev 1.14 от TypeSafe - с мультимодальностью
• Картинки: мультимодальность включается заголовком TypeSafe-Danger-Zone-Images: true
• Новый тип box: возвращает один bounding box
• Длинный контекст: TypeSafe-Danger-Zone-Long-Context: true.
На мультимодальности все модели, включая Jev, работают хуже, чем на чистом тексте
hf.co/mindlab-research/MJev-Spatial-4B
github.com/Fr0zenCrane/MJev-Spatial
#rlcd #decision #vlm
MAX
Кратко (AI)
MJev-Spatial — мультимодальная decision-модель на базе Qwen3.5-4B, которая отвечает на пространственные вопросы, выбирая из конечного набора кандидатов. В посте также сообщается о Jev 1.14 от TypeSafe с поддержкой изображений, bounding box и длинного контекста; на мультимодальных задачах модели работают хуже, чем на чистом тексте.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖