бенчмаркиСбросить фильтр ×

Опубликован технический отчет по проекту Уроборос

A@abstractDLAI-инженер
2 мес
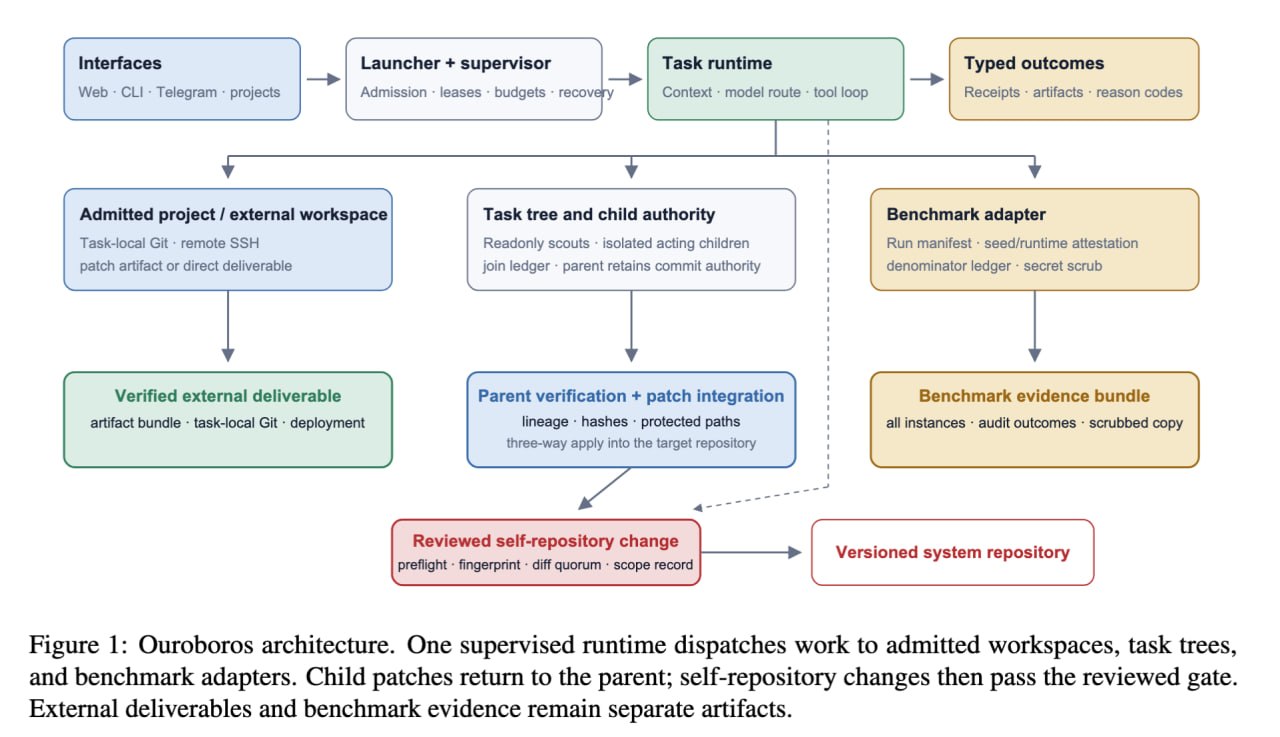
Опубликовал препринт техрепорта про Уробороса, который писали вместе с Хоуп и Романом Ямпольским. Там можно посмотреть детали про архитектуру Уробороса и Хоуп, подробнее про бенчмарки, гардрейлы и safety. Статья, GitHub, чат с Хоуп
Опубликован технический отчет по проекту Уроборос

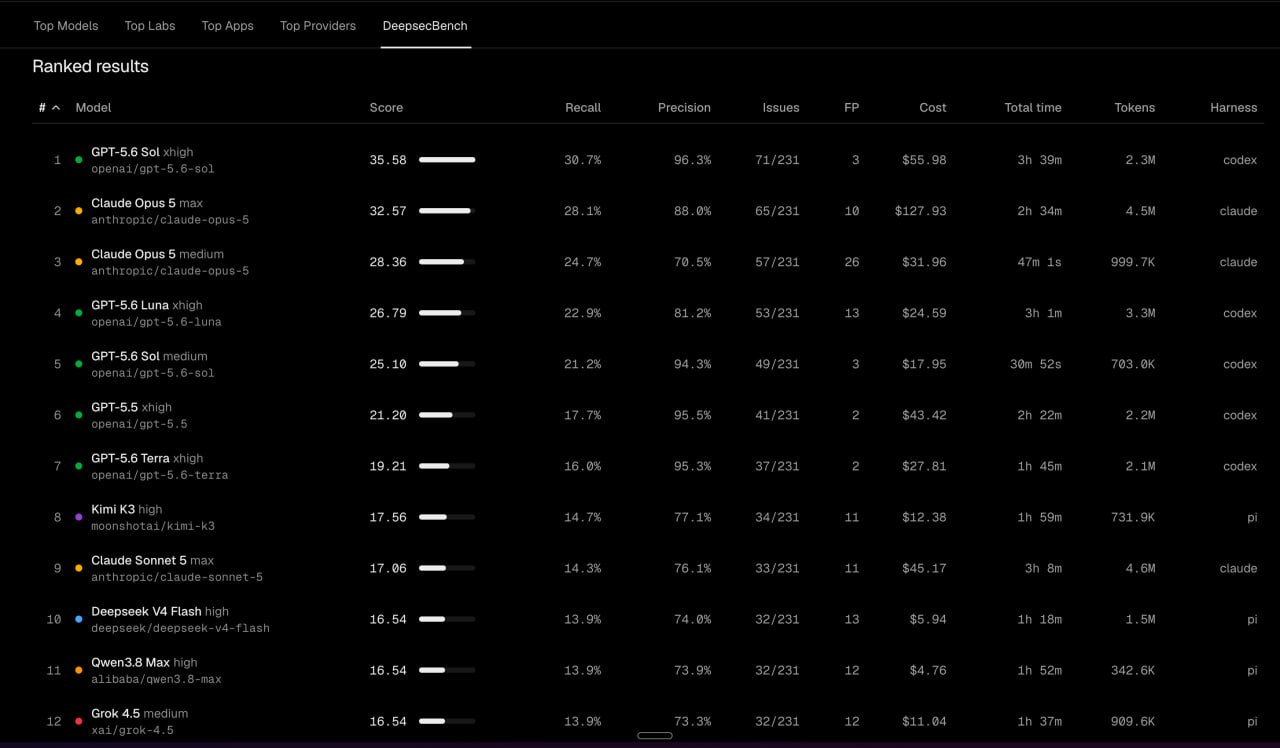
Обзор эффективности моделей Luna, Opus 5 и DeepSeek 4 Flash для Code Review

A@ai_drivenAI-инженер
2 мес
Обзор эффективности моделей Luna, Opus 5 и DeepSeek 4 Flash для Code Review

Методика оценки качества квантованных моделей

T@extremecodeAI-инженер
2 мес
Методика оценки качества квантованных моделей

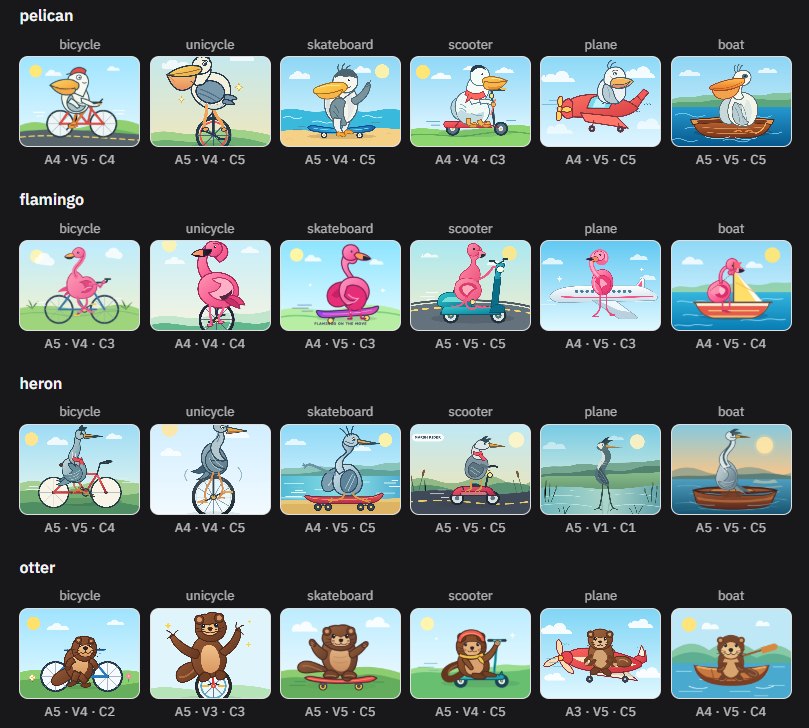
Проверка ИИ-моделей на «пеликанмаксинг»

Х@habr_comмедиа / агрегатор
2 мес
Проверка ИИ-моделей на «пеликанмаксинг»

Агент Ouroboros занял первое место на бенчмарках Terminal Bench, OSWorld и CL-bench

Автор канала AbstractDL сообщил, что его open-source агентный луп Ouroborosi, написанный на чистом Python, вышел в лидеры сразу трёх бенчмарков для AI-агентов — Terminal Bench, OSWorldi и CL-bench, обойдя Codex, Claude code, Cursor и Hermes.

По словам автора, это делает Ouroboros лучшим доступным агентом для ресёрча, работы через терминал, computer use и кодинга одновременно — и с этого момента он переводит всю свою разработку и исследования на этот инструмент.

Полный разбор →

Агент Ouroboros стал лидером на бенчмарках Terminal Bench, OSWorld и CL-bench

L@lovedeathtransformersAI-инженер
2 мес

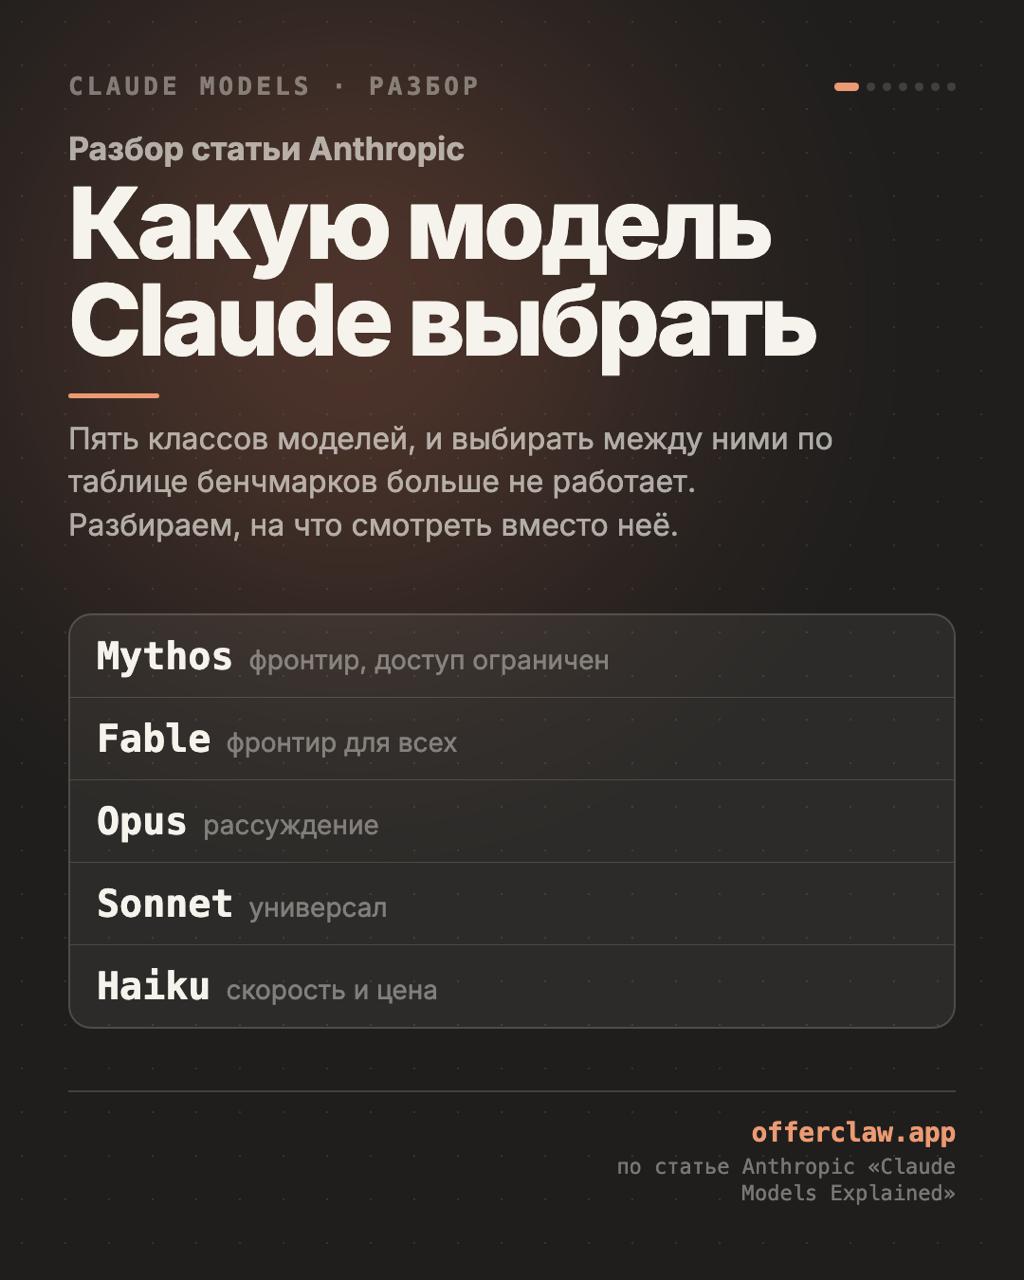
Как выбирать модели Claude: отказ от бенчмарков

Т@timurtaepovмедиа / агрегатор
2 мес
Как выбирать модели Claude: отказ от бенчмарков

OpenAI утроили результат GPT-5.6 Sol на ARC-AGI-3 (13,3%→38,3%), но обогнать Claude Opus 5 это не помогло

OpenAI выяснили, что низкий результат GPT-5.6 Sol на агентном бенчмарке ARC-AGI-3i (всего 7,8% в официальном рейтинге, где лидирует Claude Opus 5 с 30,2%) объясняется не слабостью модели, а стандартным тестовым harnessi'ом. Он после каждого шага удалял приватный ризонинг модели и обрезал историю по скользящему окну — а Sol специально обучена сохранять рассуждения между шагами игры.

Когда OpenAI прогнали Sol через Responses API с сохранением ризонинга и механизмом Compactioni (сжатие контекста вместо удаления — те же настройки, что в продакшене ChatGPT и Codex), результат на публичном сете ARC-AGI-3 подскочил с 13,3% до 38,3%, причём модель потратила в 6 раз меньше выходных токенов. Однако это кастомный харнесс, а не официальные условия теста, поэтому формально Opus 5 (30,2%) по-прежнему считается лидером — прямого превосходства Sol не доказывает.

ВыводСтандартный harness ARC-AGI-3 удаляет весь приватный ризонинг модели после каждого действия в игре

38,3%новый результат Sol с кастомным harness
13,3%старый результат Sol на стандартном harness
30,2%официальный результат Claude Opus 5

Полный разбор →
Отчет Beyond Benchmarks 2026: расходы на продажи и маркетинг

В@menngornalавтор про «startups»
2 мес
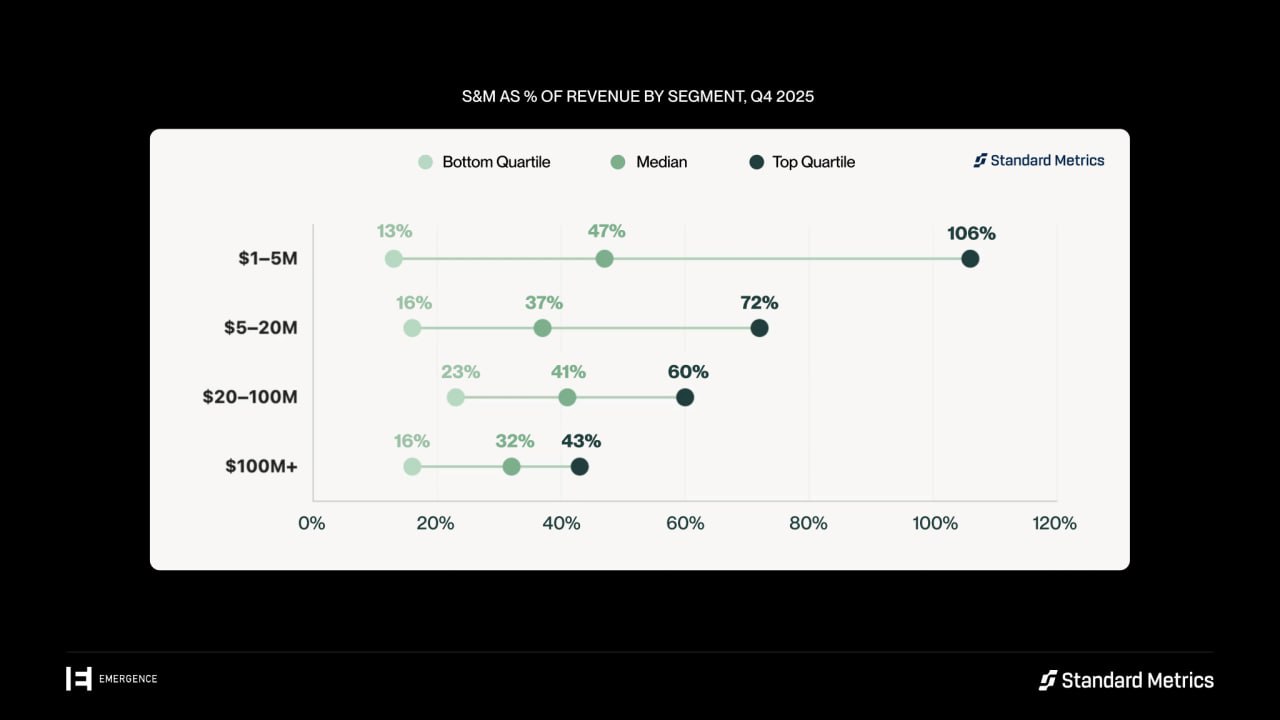
Отличный отчет о росте AI и не AI компаний. Выводы мне кажутся тенденциозными, но очень много интересных данных. Вот, например, бенчмарки по доли расходов на продажи и маркетинг. https://docsend.com/v/6syhs/beyondbenchmarks2026
Отчет Beyond Benchmarks 2026: расходы на продажи и маркетинг

Ютубер разработал собственную «гаражную» методологию оценки локальных ИИ-моделей

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Автор канала The ExtremeCode Times рассказал, почему затянулось производство видео про запуск ИИ-моделей на пачке видеокарт: изначально простая идея «взять видеокарты и запустить на них ИИ» обернулась серией вопросов, главный из которых — как вообще сравнивать между собой разные квантованные версии одной и той же модели.

В итоге вместо готового ролика появилась собственная методология оценки моделей с рабочим названием «GPU & 0-vibe Validation of Next-token Omega-quants», которую автор описывает как «на порядок лучше», чем поверхностные обзоры большинства ютуберов на эту тему.

95%доля ютуберов без практического опыта в теме
4Bразмер модели в примере поверхностного обзора

Полный разбор →

Vals-Smith: инструмент для создания кастомных бенчмарков на основе кодовой базы

3 мес
Vals-Smith: инструмент для создания кастомных бенчмарков на основе кодовой базы

Вопрос о целесообразности использования LLM-as-a-judge для оценки квантованных моделей

T@extremecodeAI-инженер
3 мес
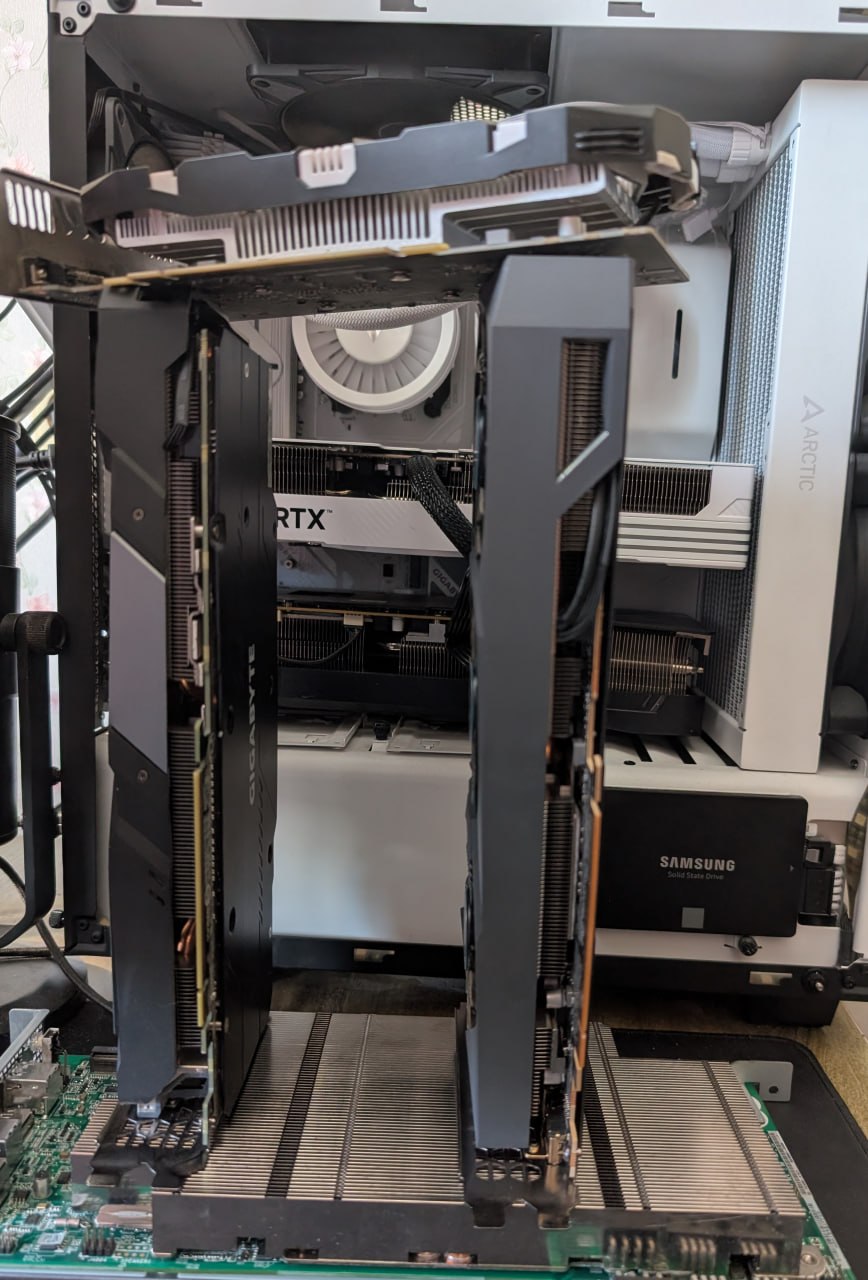
Шел 3814-ый день погружения в локальный нейрослоп. Одебилел окончательно, начал строить домики из видеокарт, до самих бенчмарков пока не добрался. Эксперты из каментов, стоит ли помимо перплексии делать простой тест на задачках из своего датасета в формате "llm as a judge"? Ну типа, я думаю нахрена на это время тратить, если разница в качестве между одной и той же квантованной моделью будет не такая сильная. Вот между Q8 и Q4 есть видимая разница. А вот между различными версиями Q4 хз как проверять. Короче, сложна.
Вопрос о целесообразности использования LLM-as-a-judge для оценки квантованных моделей

Анализ эффективности Opus 5 и мультиагентных систем

A@ai_drivenAI-инженер
3 мес
Ещё ↓