Liquid RIPL ускоряет инференс моделей LFM до 1000 запросов в секунду
Н@GreenNeuralRobotsAI-инженер
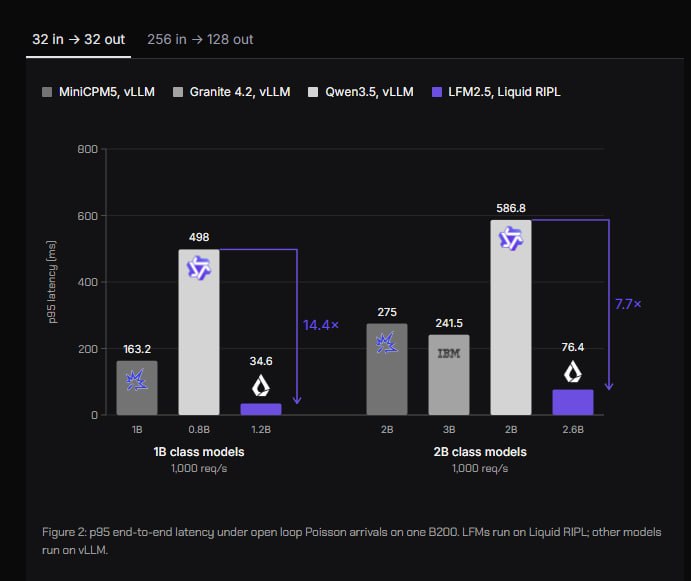
15 чLiquid RIPL обещает полный ответ менее чем за 50 мс и до 1000 запросов в секунду. Первое внедрение — поиск Shopify.
Небольшие языковые модели могут использоваться в системах, где важен ответ за доли секунды.
- Движок рассчитан на работу в критическом пути запроса, а не в пакетной очереди.
- Заявленные показатели — менее 50 мс на полный ответ и до 1000 запросов в секунду.
- Первое внедрение указано для поиска Shopify, но публичных сравнений качества пока нет.
Liquid RIPL
Движок инференса под линейку Liquid Foundation Models для задач с жестким лимитом по времени ответа. Полный ответ меньше чем за 50 мс при потоке до тысячи запросов в секунду
Ставка понятная: там, где раньше держали легкий бустинг из-за скорости, теперь можно поставить небольшую языковую модель и получить более гибкую логику. Вопрос в том, насколько качество на реальных данных перекрывает цену такого инференса, публичных замеров пока нет
Первым внедрил Shopify, в поиске
• Работа поверх модели в критическом пути запроса, а не в пакетной очереди
• Полный ответ, а не стрим по токенам с ожиданием
• Замена градиентных бустингов и векторных эмбеддингов в проде
• Онлайн-ранжирование, реклама, скоринг, антифрод
• Развертывание у клиента по запросу
• Задержка до 50 мс
• До 1000 запросов в секунду
• Только модели семейства LFM
#inference #realtime
MAX
Кратко (AI)
Liquid RIPL — движок инференса для моделей Liquid Foundation Models, рассчитанный на полный ответ менее чем за 50 мс при потоке до 1000 запросов в секунду. Первое внедрение состоялось в поиске Shopify; публичных замеров качества на реальных данных пока нет.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖