Hugging Face представили метод обучения агентов через multi-harness RL
M@ai_machinelearning_big_dataAI-инженер
3 недHugging Face предложили способ повышения точности AI-агентов через обучение в нескольких харнессах одновременно с использованием прокси-слоя.
Новый метод обучения делает AI-агентов более универсальными и эффективными в разных задачах.
- Позволяет моделям показывать стабильно высокую точность в разных тестовых средах.
- Снижает количество лишних действий агента, экономя вычислительные ресурсы.
- Доказывает, что прямое обучение через RL эффективнее простого копирования поведения больших моделей.
⚡️ Одна и та же модель набирает 62% в одном агентном харнессе и 33% в другом. Hugging Face показали, как это исправить через RL
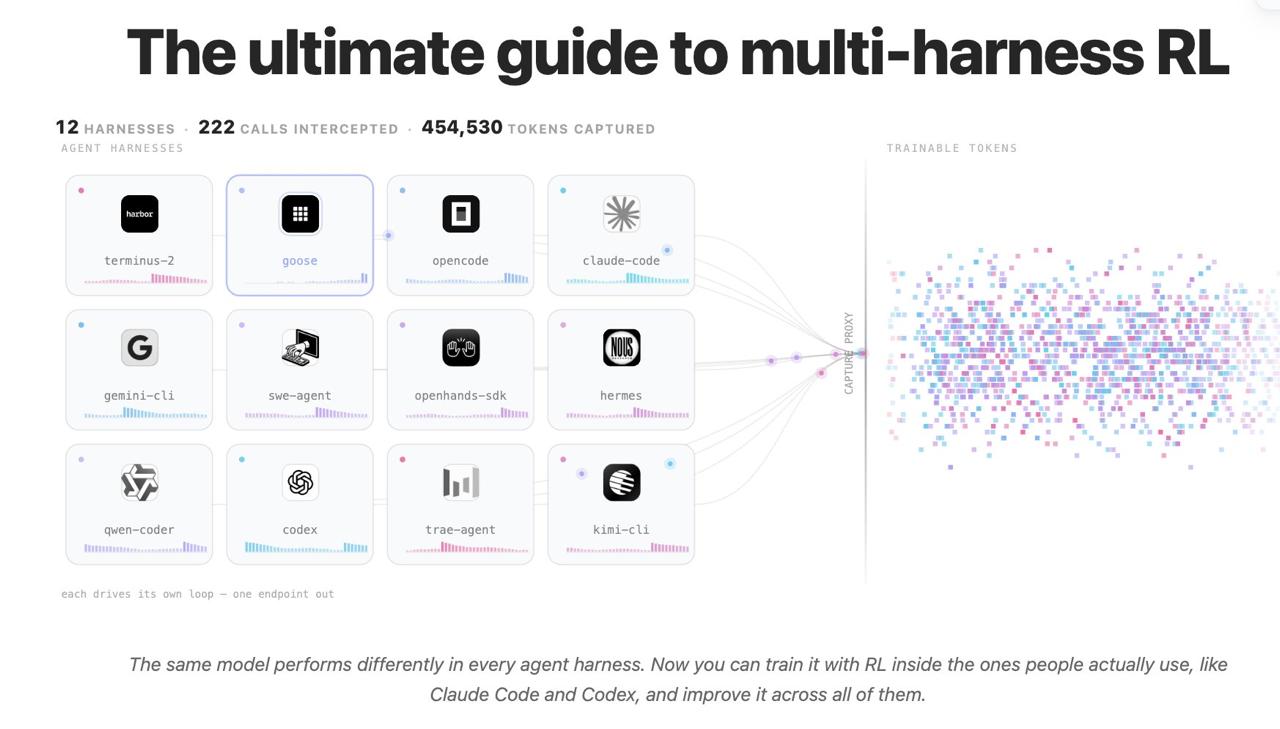
Команда Hugging Face выложила подробный гайд по multi-harness RL. Сами харнессы при этом не трогают. Модель подключают к прокси, который понимает все четыре API-формата coding-агентов: OpenAI Chat Completions, OpenAI Responses, Anthropic Messages и Gemini. Прокси записывает точные token ids и logprobs, которые семплировал vLLM, и на них идёт обучение. Claude Code, Codex и OpenCode работают как есть, без единой правки.
Результаты на LFM2.5-2.6B от Liquid AI получились такие. После обучения сразу в четырёх харнессах точность выросла с 42% до 54%. Небольшой бонус за решение задачи за меньшее число шагов сократил вызовы инструментов на 31%. Обучение только в OpenCode подняло сам OpenCode с 34% до 58%, но мульти-харнесс модель стала лучше везде.
Проверили и популярный короткий путь: SFT на 3 189 успешных траекториях Qwen3.8-27B. Имитация упёрлась в 47.5%, это ниже обоих RL-запусков. Копирование большой модели не заменяет практику в среде.
Открыто всё: прокси для записи траекторий в OpenEnv, тренер в TRL (async GRPO), задачи, SFT-данные, код и семь обученных моделей.
https://huggingface.co/spaces/AdithyaSK/multi-harness-rl
@ai_machinelearning_big_data
#HuggingFace
Кратко (AI)
Команда Hugging Face представила метод multi-harness RL, позволяющий обучать AI-агентов сразу в нескольких средах тестирования без изменения самих харнессов. Использование прокси-слоя для сбора данных и обучение через GRPO позволило значительно повысить точность моделей, превзойдя результаты обычного SFT.
Обсуждение
2вот это да, разброс 62% против 33% получается просто от того что модель не понимала формат конкретного харнесса, а не от её реального качества. мульти-харнесс RL эту иллюзию снимает. интересно насколько бенчи на одном харнессе теперь вообще можно всерьез воспринимать
да не, тут модель просто тупила на одном формате api а на другом нет, вот и всё. мульти-харнесс рл это убирает, но бенчи всё равно по большей части мерят адаптацию к обвязке а не саму задачу