Анализ эффективности модели Jev для антиспам-фильтрации
L@lovedeathtransformersAI-инженер
3 недРазбор возможностей специализированной модели Jev от Typesafe для структурированной классификации и её применимости в антиспам-системах.
Специализированные модели могут быть дешевле универсальных LLM для простых задач классификации.
- Jev позволяет получать структурированные ответы (да/нет) вместо генерации текста.
- Использование таких моделей может снизить затраты на API в разы при правильной настройке критериев.
- Главный риск — баланс между пропусками спама и ложными срабатываниями, требующий гибридного подхода.
Не знаю, слышали ли вы про новую инновационную модель Jev от Typesafe, но мне про неё уже написали пять человек в личку и ещё двое — в комментариях 🧐
Если говорить просто, Jev — это специализированная модель для получения структурированных вероятностных ответов. В отличие от обычных LLM, она не генерирует текст, а за один запрос может параллельно отвечать на заранее заданные вопросы. При этом ответы будут просто «да» или «нет» с некоторой вероятностью.
Такую модель можно использовать, в том числе, для антиспама. Технически можно просто спросить у неё «это спам?», но на деле это не сработает. Тут нужно самостоятельно разложить задачу на набор критериев, задать модели отдельные вопросы, а уже потом объединить полученные ответы и принять итоговое решение.
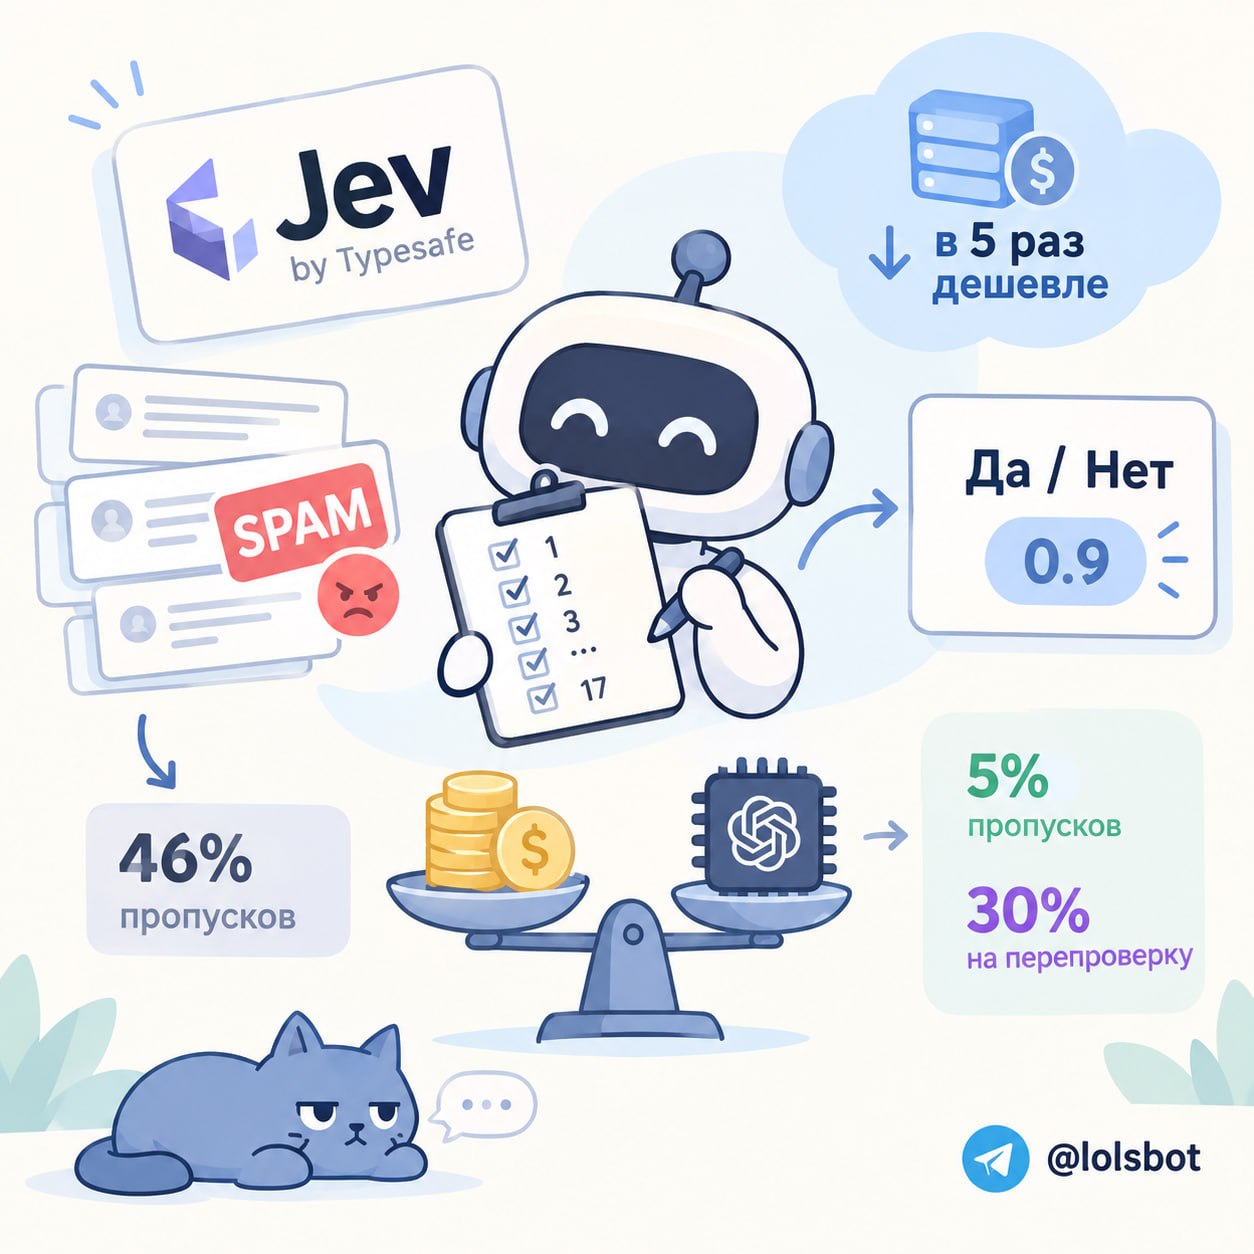
В качестве примера можно посмотреть критерии в jev_antispam_bot: он задаёт модели 17 вопросов, а для принятия решения использует порог вероятности 0.9.
Если прогнать по этим критериям тот спам, который за прошедшие сутки обнаружил @lolsbot, то на моей выборке получится 46% пропусков, но при этом решение задачи будет примерно в 5 раз дешевле по сравнению с gpt-4.1-mini.
Идеального результата по отсутствию пропусков на этой выборке можно добиться, если снизить порог до 0.05. Но в таком случае количество ложных срабатываний существенно вырастает — до 84%, поэтому полагаться на такой результат без дополнительной проверки нельзя.
Нечто среднее можно получить при пороге 0.15–0.20: около 5% пропусков, при этом примерно 30% сообщений придётся дополнительно перепроверять через более умную модель.
После длительных тестов и сложных вычислений получилось, что Jev вполне реально интегрировать в Lols в качестве предварительного фильтра. Это позволит примерно вдвое снизить затраты на OpenAI, а около 30% от сэкономленных денег отдавать за использование Jev.
По моим тестам, качество антиспама при этом существенно не изменится, зато добавится ещё одна внешняя зависимость.
Стоит ли оно того? Как по мне — нет.
На самом деле есть смысл обучить свой классификатор, но руки до этого так и не дошли. А на видяху за год так и не собрали денег, поэтому придётся пользоваться облачными провайдерами и опять тратить деньги 🫠
Кратко (AI)
Автор анализирует новую модель Jev от Typesafe, предназначенную для получения структурированных вероятностных ответов. В ходе тестов на антиспам-задачах выяснилось, что модель позволяет снизить расходы на API в сравнении с gpt-4.1-mini, однако требует сложной настройки порогов вероятности и не исключает ложных срабатываний. Автор приходит к выводу, что внедрение Jev нецелесообразно из-за появления новой внешней зависимости.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖