Бенчмарк моделей Sol 6.1, Sonnet 5.5 и Opus 5.5
L@llm_under_hoodAI-инженер
4 недАнализ производительности и стоимости новых моделей Sol 6.1, Sonnet 5.5 и Opus 5.5, а также проблемы с отказами у Anthropic.
Оптимизация затрат на AI-инфраструктуру через выбор более эффективных моделей.
- Модель Sol 6.1 Low позволяет снизить расходы при сохранении качества для задач с Schema-Guided Reasoning.
- Новые модели Anthropic (Sonnet 5.5, Opus 5.5) показывают высокую частоту необоснованных отказов в ответах.
- Выбор модели теперь требует учета не только качества, но и стабильности поведения в специфических сценариях.
Бенчмарк GPT-6.1 Sol - аналогичное качество за меньшие деньги
А еще Sonnet 5.5 и Opus 5.5
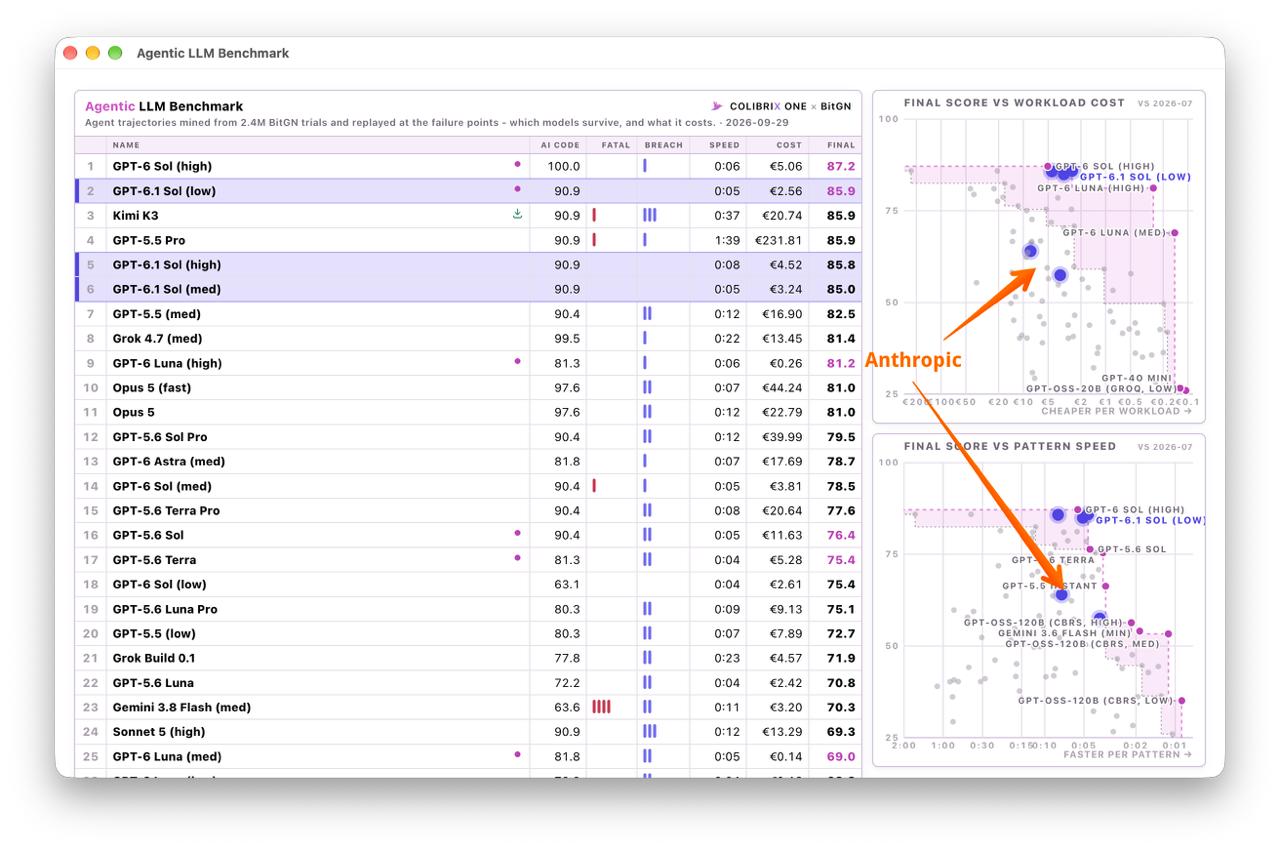
Sol 6.1 на бенчмарках (на датасетах agentic trajectories из BitGN) по качеству примерно на уровне Sol 6.0 High, но заметно дешевле и немного быстрее.
Прорыва по качеству нет, но есть небольшое и стабильное снижение стоимости за то же качество. Это немного сдвигает AI фронтир вправо.
Почему Sol 6.1 Low работает чуть лучше High + Med - сложно сказать. У меня есть подозрение, что отключение reasoning благоприятно влияет на Schema-Guided Reasoning. Аналогичное, если помните, было с моделями вроде GPT-oss-120B, когда они только выходили и начинали дружить с constrained decoding. Я из интереса перезапустил бенчмарк 6.1 - ответы были точно такие же.
Самое главное - если у вас используется SGR - попробуйте Sol 6.1 Low для экономии денег.
Что же касается Sonnet 5.5. + Opus 5.5 - это две синие точки в самой глубине освоенного фронтира. Последние модели от Anthropic - абсолютные лидеры среди всех моделей в области числа fatal refusals (отказов выдавать ответ). Причем:
(1) у Sonnet 5.5 был бы шанс подовинуть фронтир по скорости и качеству, если бы не эта особенность.
(2) Opus 5 + Sonnet 5 еще работали нормально, а беда с моделями Anthropic началась после выхода Fable
Кстати, зона покрытия фронтира - это прогресс развития моделей в области качества за деньги и качества при скорости с июля этого года. Состояние этого фронтира и отчет за июль 2026 (с большим числом подробностей про бенчмарк) мы опубликовали на сайте BitGN. Отчет на текущий момент тоже скоро планируется.
Ваш, @llm_under_hood 🤗
Кратко (AI)
Автор анализирует производительность новых моделей Sol 6.1, отмечая их экономическую эффективность при сохранении качества уровня Sol 6.0 High. Также обсуждаются проблемы с частыми отказами в ответах у новых моделей Anthropic (Sonnet 5.5 и Opus 5.5) и их влияние на использование в задачах с Schema-Guided Reasoning.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖