R4T: ускорение multi-hop RAG через диффузионные модели
D@dealerAIAI-инженер
4 недОбзор метода R4T от Google: использование RL и диффузионных моделей для генерации подзапросов в RAG без авторегрессионных задержек.
Новый метод позволяет поисковым системам работать значительно быстрее и точнее при обработке сложных запросов.
- Устраняет задержки, связанные с пошаговым планированием запросов в LLM.
- Повышает релевантность выдачи за счет генерации разнообразных подзапросов.
- Технология позволяет внедрять сложные RAG-системы в продукты с жесткими требованиями к latency.
Retriev for train, учим google поиск работать с подзапросами в неявном виде. 💻
Вышла интересная работа в бложике Google, в которой ребятки показывают как можно делать multi hop RAG без явной генерации подзапросов на запрос.
Суть проблемы. Современные поисковые системы должны возвращать на запрос не одну лучшую ссылку, а связный набор взаимодополняющих результатов на первой странице. Например, на запрос "походное снаряжение" – поварешку, миску ложку, два батона колбасы, палатку, спальник, горелку, фонарь. 😁
Для этого используется техника query fan-out: один широкий запрос разбивается на несколько подзапросов, которые составляют полную группу кандидатов на ответ исходного запроса.
Однако научить LLM делать это динамически дорого, ввиду:
- Коллапса парафраз, те без оптимизации под базу данных zero-shot LLM генерируют почти одинаковые по смыслу подзапросы.
-Задержка авторегрессия. LLM вынуждены генерировать сотни промежуточных цепочек рассуждений, чтобы спланировать разбиение. Это дорого + создаёт рост latency. Те время на ответ растёт. 😐
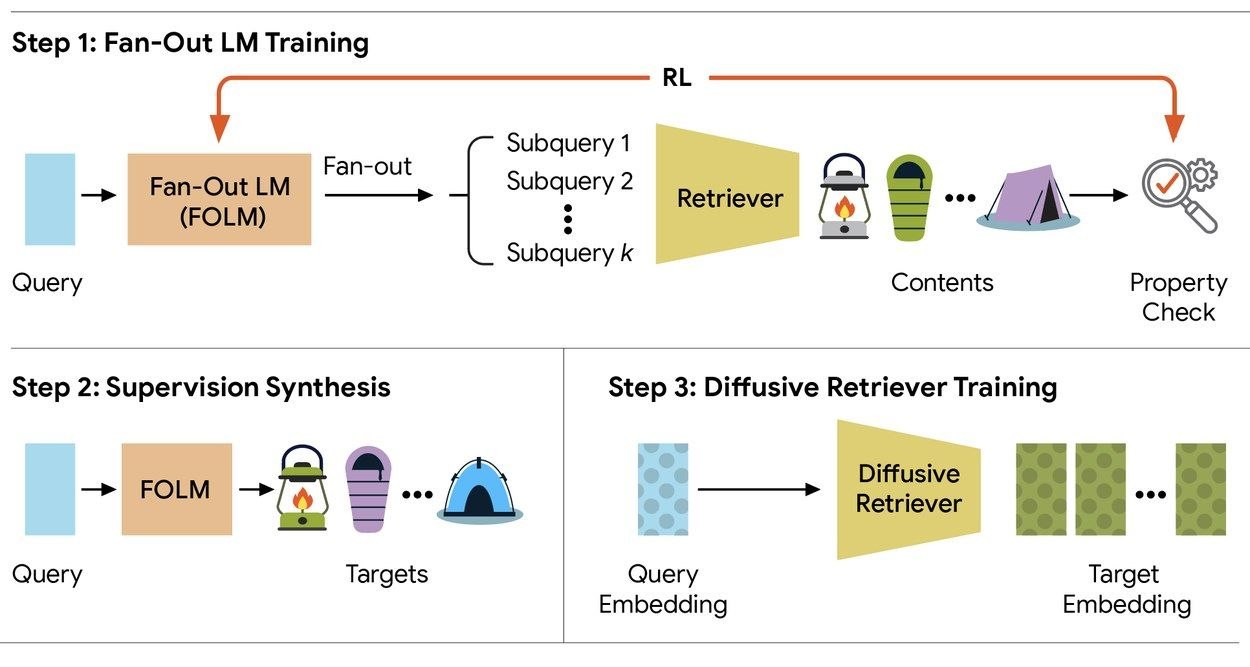
Че делать? Тут и придумали R4T. Идея один раз обучить модель через RL на генерацию нужных подзапросов, а потом сдистиллировать её поведение в лёгкую диффузионную модель, которая работает за один проход. 🧠
Подробнее:
1. RL-обучение. Делают FOLM модель на основе Qwen3 4b или Gemma3 такого же размера. FOLM генерирует подзапросы в виде текста и получает награду по трём критериям:
· Groundedness подзапрос должен соответствовать реальному объекту в базе поиска. Через среднее эмбеддинг расстояние между запросами в базе и подзапросом.
· Diversity измеряется через оценку семантического разнообразия фраз, зовут это Vendi Score, чтобы не было синонимов. Я бы тут брал угловые расстояние между эмбами подзапросов, нормы векторов и сравнивал это. Но над бы пороги подбирать. А тут красиво, через собственные значения векторов. Что показывает на сколько соноправлены эти вектора + угол. Что я и хотел придумать выше. 🌿
· Alignment привязка к исходному запросу, чтобы не уйти в семантический дрейф и не улететь по теме не туда. Логично, что каждый эмб подзапроса сравнивают с эмбом запроса.
Итого нам не нужна никакая иная модель судья кроме эмбеддера векторной базы знаний. При этом сам эмбеддер мы не меняем, не тюним и тп.
Далее крч, на этом учится модель FOLM через RLVR. Потом модель генерирует К траекторий подзапросов. Они эмбеддятся и идут на обучение диффузионного эмбеддера, всего на 53,9 млн параметров. Он учится по паре эмбеддинг запроса → набор целевых эмбеддингов подзапросов. Важно, что FOLM генерирует именно текст, а затем внешний эмбеддер превращает его в векторы. Диффузионная модель уже работает с готовыми векторами.
За счёт этих фокусов мы на проде получаем на запрос в поиск сразу К эмбов подзапросов без промежуточных рассуждений в токенах.
Результат впечатляющий:
· Ускорение в 12–20 раз.
Авторегрессионные подходы до 50 секунд.
R4T доли секунды/несколько секунд.
· Качество выше, чем у zero-shot и Best-of-N.
Естественно приходится за скорость платить пайпом из М шагов обучения. Чудес не бывает. 😏
Кратко (AI)
В блоге Google представлен метод R4T, позволяющий оптимизировать multi-hop RAG системы. Вместо дорогостоящей генерации подзапросов через LLM, авторы используют RL для обучения модели, поведение которой затем дистиллируется в легкую диффузионную модель. Это позволяет генерировать эмбеддинги подзапросов за один проход, ускоряя поиск в 12–20 раз при сохранении высокого качества.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖