Сбер представил новое поколение моделей GigaEmbeddings
Н@GreenNeuralRobotsAI-инженер
1 месСбер выпустил три новые модели GigaEmbeddings (480M, 3B, 10B-A1.8B) для семантического поиска и RAG, показав рост производительности и качества.
Обновление инструментов для работы с данными позволяет компаниям быстрее и точнее искать информацию в своих базах знаний.
- Ускорение работы моделей на vLLM до 2 раз сокращает время отклика поисковых систем.
- Улучшенное качество векторизации повышает точность ответов нейросетей в RAG-системах.
- Новые модели позволяют эффективнее автоматизировать сортировку и анализ больших объемов документов.
Сбер опубликовал новое поколение GigaEmbeddings
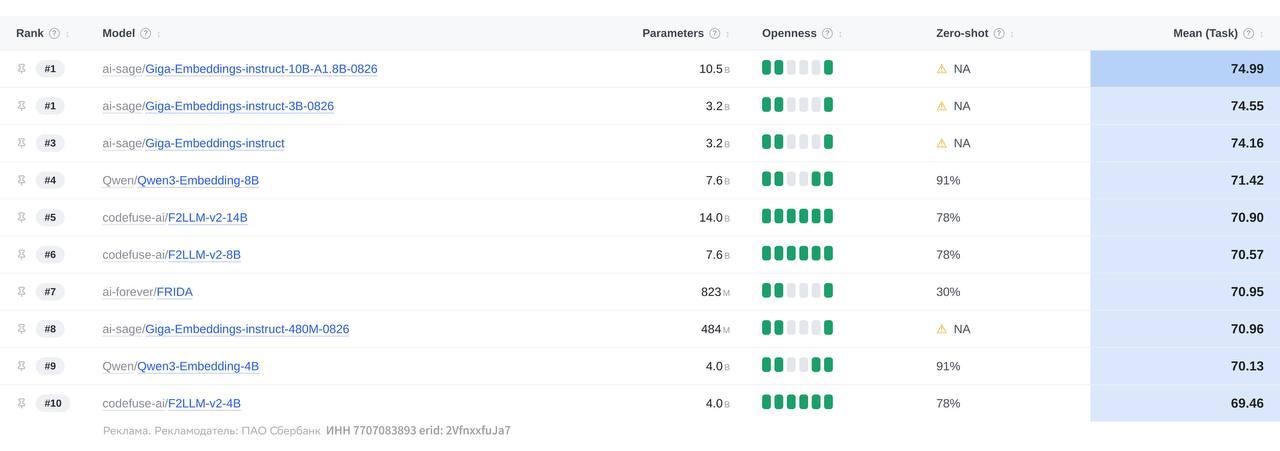
Три модели - 480M, 3B и 10B-A1.8B. Переводят текст в векторы для семантического поиска, RAG, классификации и кластеризации.
модели нужны, чтобы находить похожие по смыслу тексты, строить поиск по базе знаний и подключать ее к нейросетям, а также раскладывать документы по темам и категориям.
На vLLM 3B работает в 1,6 раза быстрее прошлой версии, 10B-A1.8B - в 2 раза.
10B-A1.8B заняла первое место в ruMTEB, у 3B качество кода выросло на 14,5 пункта, а 480M стала лучшей по русскому языку среди моделей до 500М параметров.
HF
#search #embeddibgs
VK | MAX
Кратко (AI)
Сбер выпустил обновленную линейку моделей GigaEmbeddings, включающую версии 480M, 3B и 10B-A1.8B. Новые модели предназначены для задач семантического поиска, RAG и классификации, демонстрируя значительный прирост скорости на vLLM и лидерство в бенчмарке ruMTEB.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖