#обзор_статьи
Давно здесь не было обзоров статей. Но несмотря на вайбкодинг я не разучился читать.
Сегодня у нас впервые за долгое время заявка на смену парадигмы в генеративном DL!
# Explorative Modeling: Unlocking a Third Pretraining Axis and End-to-End Generation
https://explorative-modeling.github.io/
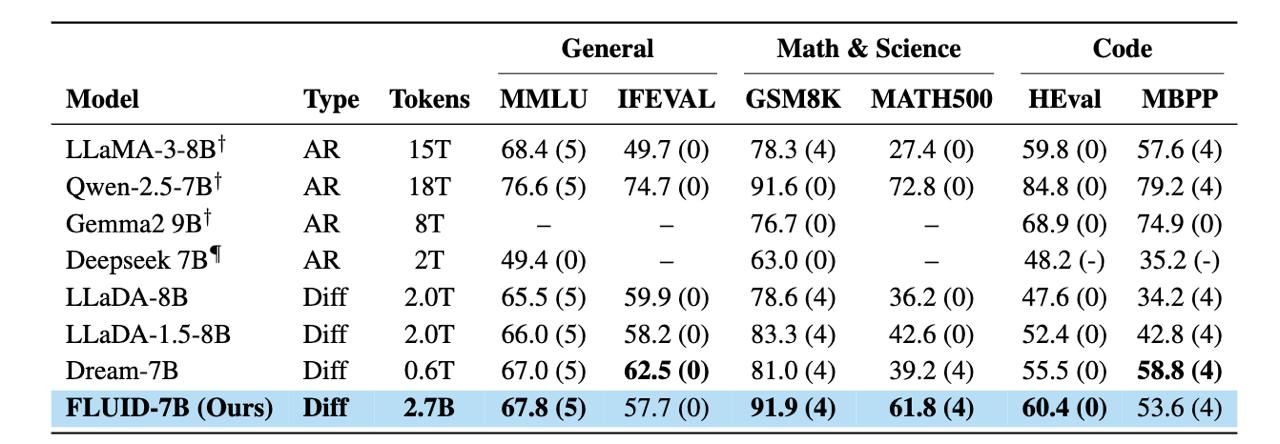
Авторы предлагают учить генеративные модели другим лоссом который имеет теоретические основания и одновременно улучшает эффективность использования компьюта, качество и скейлинг с параметрами.
Ключевая идея: мы учим генеративные модели одним образом, а инферим их совсем иначе. Например, авторегрессионные модели генерируют один токен за раз, но при инференсе мы требуем от них тысяч токенов на выходе. Диффузионные модели в трейне денойзят один шаг, а при инференсе должны делать готовую картинку. При этом, например, у диффузионной модели часто нет возможности по вектору шума понять в какую именно сторону его надо денойзить, но мы её штрафуем как будто это однозначно определено.
Так сложилось потому что генеративные модели пытаются учить мультимодальные распределения. Условно где много гауссиан намешано: в одной части латентного пространства собаки, а в другой кошки и надо научиться генерировать фото обоих. Если пытаться генерировать за один шаг, то модель не может сделать ничего лучше, чем выдать нечто среднее. Пошаговая генерация это хак, который позволяет семплировать не из p(данные), а из p(данные|мы уже начали генерировать собаку), и таким образом дают модели возможность выбрать одну из мод распределения и фокусироваться на ней. Хаки это плохо, потому что разные процедуры обучения и инференса гарантируют сдвиг входов. И вообще надо, чтобы всё было end-to-end.
Предлагают простое решение: во время обучения делать несколько попыток генерации, а бекпропать только самую близкую к данным. Утверждается, что такая постановка позволяет модели поисследовать разные моды распределения, а не натягивать любую сову на один глобус.
На примере диффузии работает так. Для каждого примера:
1. Семплируем K разных способов его зашумить.
2. Для каждого из K делаем предикт моделью, чтобы уменьшить шум и считаем обычный диффузионный лосс.
3. Бекпропаем только
наименьший из полученных лоссов.
Так же предлагают процедуру как учить такую Exploration Model с нуля.
Если всё как авторы утверждают, то это имеет потенциал улучшить весь генеративный DL повсеместно, от LLM до генераторов порно до VLA которыми мы занимаемся в Steelman