KDD’26, день четвертый.
Сегодня в основном вел закулисные разговоры, про которые не могу ничего рассказать. А вот про что могу:
1. Доклад от команды YouTube и GDM. Классический формат выступления, когда они рассказывают про свои новые статьи. Судя по всему, у них прям очень жестко цензурируются любые рассказы наружу, ничего лишнего упоминать нельзя, поэтому они придерживаются формата пересказа уже опубликованных статей.
Держите еще одно название для кандгена —
nomination. А для преранжирования —
prescoring. А группировку айтемов в выдачу в докладе нарекли
packing.
В рамках доклада выступало поочередно четыре человека. Сначала был рассказ про knowledge distillation в ранжировании:
* упоминали две свои более старые работы —
Bridging the Gap: Unpacking the Hidden Challenges in Knowledge Distillation for Online Ranking Systems и
Zero-shot Cross-domain Knowledge Distillation: A Case study on YouTube Music
* и как раз на KDD’26 у них вышла новая статья —
Addressing Intent Dissonance in Cross-Domain Distillation on YouTube. Кто первый прочитает, напишите в комментариях что там :)
Затем был раздел про анализ последовательностей:
* упоминали нашу любимую
Top-K Off-Policy Correction for a REINFORCE Recommender System, а также оригинальный
YoutubeDNN, в котором впервые предложили next watch prediction
* затем показали свою новую работу
ClockRoPE: Random Fourier Rotations for Temporal Routine Modeling, в которой, как я понял, сделали time-aware RoPE, то есть учли время при анализе последовательности
* и еще одну новую работу
Tokens are All You Need: Dual-purpose Semantic IDs for Achieving LLM-Level I/O Efficiency in recommendation systems. Заменили в рекомендательной нейросети эмбеддинги на семантические айдишники
Потом говорили про LLM x RecSys:
* упомянули
TIGER, а также статью про
semantic IDs для ранжирования в YouTube,
PLUM,
STATIC
*
Token Factory: Efficiently Integrating Diverse Signals into Large Recommendation Models. Заменили в LLM семантические айдишники на эмбеддинги :)
*
LLM-Based User Personas for Recommendations at Scale. Используют LLM для exploration с помощью генерации новых для пользователя интересов
*
TokenMinds: Pretrained User Tokens and Embeddings for User Understanding in Large Recommender Systems. Делают семантический айдишник пользователя. У меня в этом году студент такую дипломную работу в бакалавриате вышки защитил))
Последняя, четвертая секция называлась Gemini Commercial Intelligence:
* это как раз работы команды Derek Cheng, подарившей миру DCN-v2
* как и писал в прошлом посте, делают ИИ-ресерчера, который их заменит (ну и нас тоже, за компанию). Прикладываю статьи ниже
*
AgenticTagger: Structured Item Representation for Recommendation with LLM Agents
*
PACEvolve: Enabling Long-Horizon Progress-Aware Consistent Evolution
*
PACEvolve++: Improving Test-time Learning for Evolutionary Search Agents
* также активно занимаются бенчмарками для этого ИИ-ресерчера. Статья
Evo-Memory: Benchmarking LLM Agent Test-time Learning with Self-Evolving Memory
* еще делают модель, которая по набору товаров будет генерировать рекламу, в которой эти товары присутствуют. Звучит немного рандомно, но в тему коммерциализации укладывается
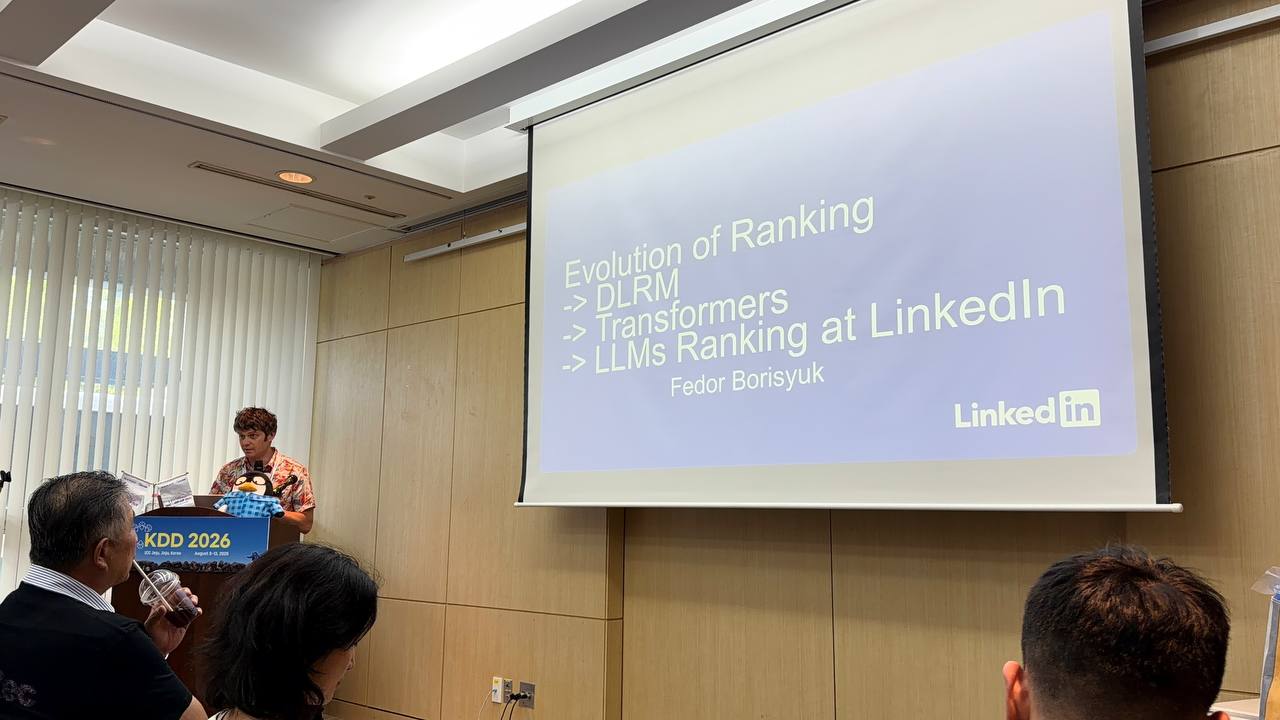
3. Был доклад от Федора Борисюка про эволюцию ранжирования в Линкедине. Подсвечу лишь статью
Semantic Search At LinkedIn; вроде как это их главная работа про ранжирование на текущий момент. Федор, как всегда, первый автор :)