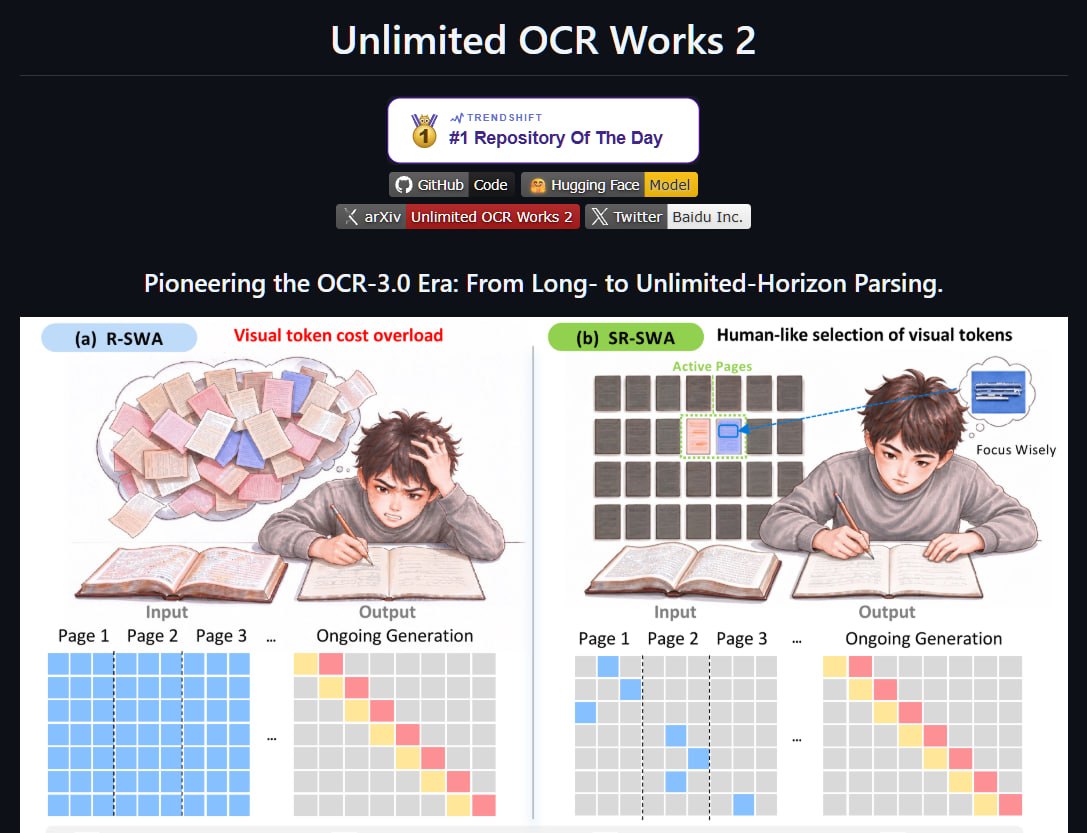
ИИbaiduunlimited-ocr 2ocrдокументыраспознавание текстаBaidu представила Unlimited-OCR 2 для распознавания длинных документовМ@cgeventAI-инженер21 чBaidu бахнула Unlimited-OCR 2: модель для распознавания документов практически любой длины Она умеет извлекать текст из сканов и PDF, обрабатывать таблицы, формулы и многостраничные материалы. Но главная новизна работы не столько в качестве OCR, сколько в способе обработки очень длинных документов. У современных OCR-моделей на базе LLM есть проблема: чем больше страниц они обрабатывают и чем длиннее становится генерируемый текст, тем больше вычислений и памяти требуется для продолжения работы. Модель вынуждена постоянно обращаться к растущему объёму предыдущего контекста. Первая Unlimited-OCR уже частично решала эту проблему, ограничивая объём сохраняемой истории генерации. Но визуальные данные всех страниц по-прежнему могли создавать растущую вычислительную нагрузку. В Unlimited-OCR 2 Baidu предложила механизм Sparse Reference Sliding Window Attention (SR-SWA). Его идея довольно проста: при распознавании очередного фрагмента модель сосредотачивается на текущей странице и обращается лишь к небольшому набору наиболее полезных фрагментов из остального документа. Вместо постоянного просмотра всей накопленной информации она использует ограниченную рабочую память - например, 512 опорных токенов. В результате вычислительная стоимость каждого следующего шага остаётся приблизительно постоянной, даже когда документ становится значительно длиннее. Все как у кожаных: переписывая длинную книгу, мы смотрим прежде всего на текущую страницу, а не перечитываем все предыдущие после каждого предложения. Что на итоге? По собственным тестам Baidu, на документах объёмом около 100 страниц новый механизм обеспечивает ускорение отдельных шагов декодирования до 7 раз относительно полного внимания и до 5.6 раза относительно предыдущего механизма. Дополнительно модель использует обработку страниц перекрывающимися блоками, что позволяет освобождать память после завершения очередного участка документа. Модель содержит около 3 млрд параметров. Код и веса опубликованы под лицензией MIT, в том числе для коммерческого использования. Ссылки: • GitHub: https://github.com/baidu/Unlimited-OCR • Веса: https://huggingface.co/baidu/Unlimited-OCR-2 • Статья Unlimited-OCR: https://arxiv.org/abs/2606.23050 @cgeventbaiduunlimited-ocr 2ocrдокументыраспознавание текста
ИИПродуктбизнес-процессыдокументырегламентычек-листыиивнедрениеИИ помогает быстро создавать документы для бизнес-процессовП@pogovorim_za_dengi_nadiaмедиа / агрегатор5 чСистемы в бизнесе Продолжаю над этим работать, за две недели наклепала 12 документов в самых разных форматах - от серьёзного документа на десять страниц до чек-листов, презентаций и карточек исполнения. Темы разные: от чек-листа, как проводить встречи один на один со своими сотрудниками, до проверки Яндекс.Карт и стандартов сервиса. Сначала все процессы были изложены просто на бумаге, документы, а потом я осознала, что в современных реалиях внимание необходимо держать, даже если это всем нужно. Поэтому форматы совершенно разные. Какие выводы? Первое. Эпоха продуктов в инфобизе из серии «вот вам регламенты, инструкции и чек-листы, а я расскажу, как это делать» потихоньку уходит в лету. Потому что с таким помощником, как Клод, всё это делается достаточно быстро, даже если, как мне кажется, человек не такой эксперт, как я, но могу ошибаться. Второе. Для того чтобы описать/создавать системы в бизнесе, сегодня, по сути, вообще никто не нужен, нужен опыт и понимание. Третье. Помимо того чтобы эти бизнес-процессы описать, нужно ещё их внедрить, причем желательно без напряжения, а для этого тем, для кого ты это внедряешь должно быть просто-понятно-удобно, как бы базовая вещь, но почему-то не всегда так. А самое главное - всё это нужно было сделать намного раньше. Я годами это откладывала, все время пытаясь найти, кому бы это поручить. Сегодня все намного проще. Славься ИИ!!!бизнес-процессыдокументырегламентычек-листыиивнедрение