MTGBench оценивает пользу длинных рассуждений моделей
К@d_codeмедиа / агрегатор
1 чСтуденты ШАДа и исследователи Яндекса выпустили открытый бенчмарк MTGBench для оценки пользы рассуждений в игровых задачах.
Бенчмарк помогает понять, когда более дорогие рассуждения ИИ действительно улучшают ответ.
- Тесты показывают, что польза рассуждений зависит от типа задачи.
- В некоторых задачах дополнительные рассуждения увеличивают затраты без заметного прироста.
- Результаты также зависят от языка задания.
🙂 Бенчмарк, который считает деньги
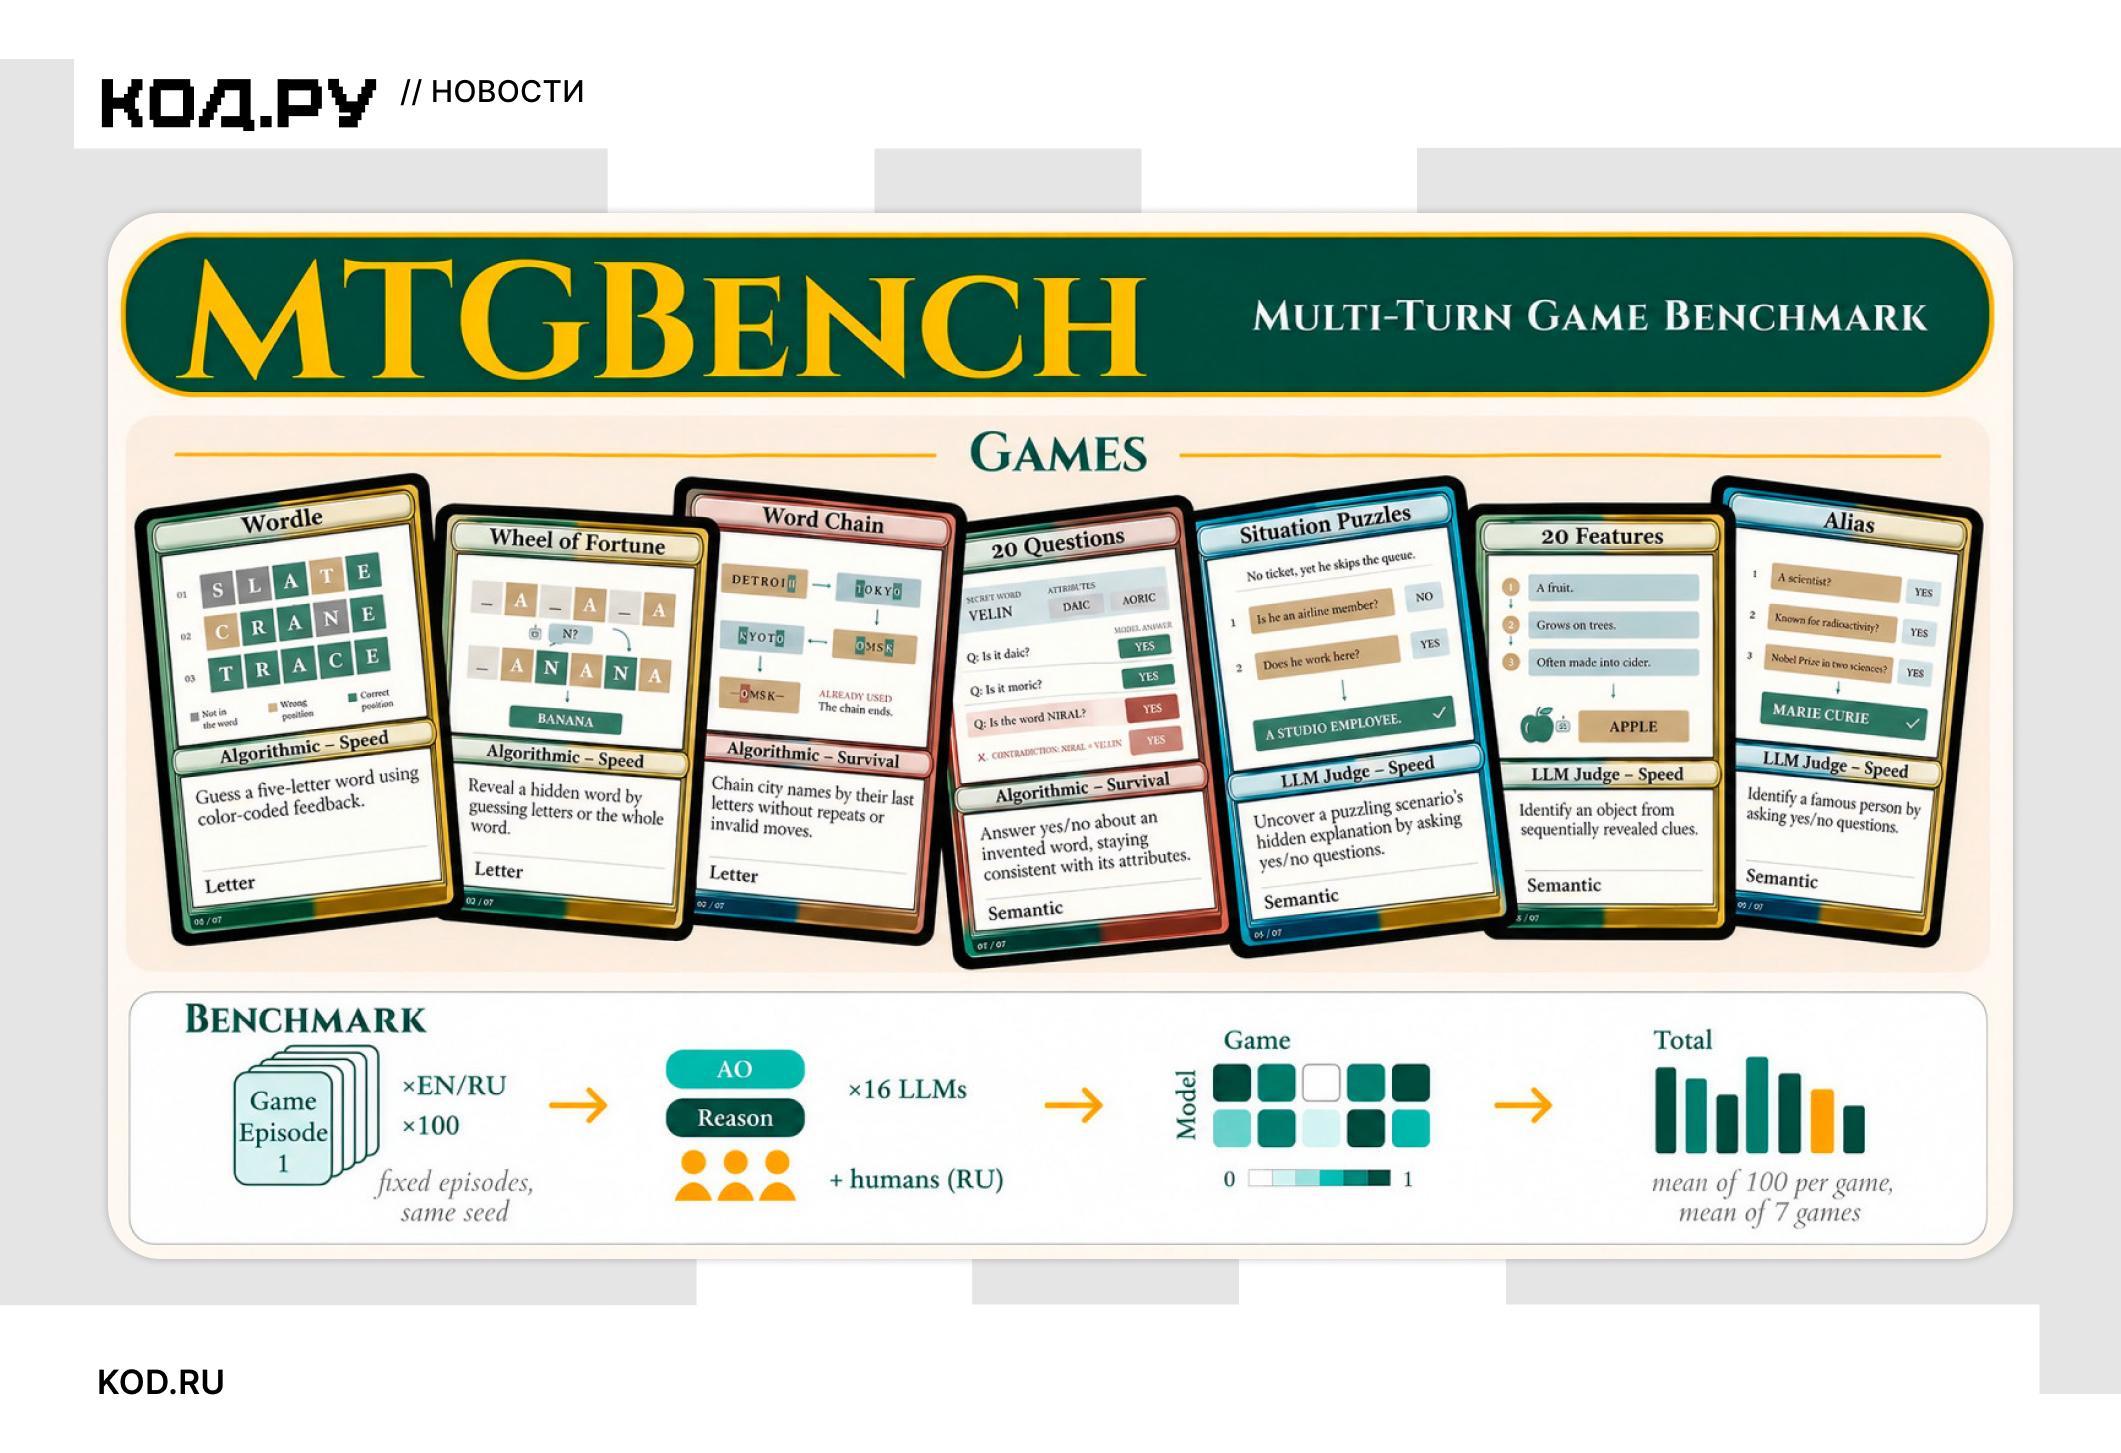
Длинные рассуждения делают ответы нейросетей дороже, но не всегда точнее — студенты ШАДа и исследователи Яндекса выпустили открытый бенчмарк MTGBench, который помогает понять, где они окупаются.
📌 Внутри семь игровых испытаний на русском и английском. Модель проверяют по шагам: планирование, логика, работа со знаниями, учёт новой информации, непротиворечивость выводов.
📌 Среди 16 протестированных моделей — разработки OpenAI, Google, DeepSeek и Qwen. Рассуждения сильнее всего помогли в задачах с символами и анализом подсказок.
📌 А вот в извлечении знаний и понимании смысла прирост оказался заметно меньше и сильно зависел от модели. Там дополнительные рассуждения чаще только добавляют стоимости.
📌 При выборе модели авторы советуют смотреть не только на общий рейтинг, но и на язык: в части заданий русский даётся моделям тяжелее.
Сообщается, что MTGBench уже доступен на GitHub, а статью о нём приняли на EMNLP 2026 — одну из ведущих конференций по обработке естественного языка.
💻 Подписаться
Кратко (AI)
Студенты ШАДа и исследователи Яндекса представили открытый MTGBench с семью игровыми испытаниями на русском и английском языках. По результатам тестов, дополнительные рассуждения особенно помогали в задачах с символами и анализом подсказок, но в извлечении знаний и понимании смысла часто давали небольшой прирост при дополнительных затратах.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖