Яндекс представил MTGBench и оценщики ORBIT для проверки LLM и переводов
D@data_secretsAI-инженер
1 чНа EMNLP опубликованы исследования Яндекса: игровой двуязычный бенчмарк MTGBench и семейство оценщиков переводов ORBIT.
Новые инструменты могут сделать проверку рассуждений моделей и ошибок перевода более масштабируемой и дешёвой.
- MTGBench проверяет модели в семи многоходовых играх на русском и английском языках.
- В тестировании 16 моделей сильные reasoning-модели сравнялись с человеческим бейзлайном или превзошли его.
- Лучшая конфигурация ORBIT достигла экспертного уровня согласованности в поиске ошибок перевода.
- Оценка ORBIT стоит примерно в 28 раз меньше одного прохода профессионального эксперта.
Исследователи из Яндекса опубликовали на EMNLP две новые статьи про оценку LLM
EMNLP 2026 — это одна из двух главных NLP-конференций вместе с ACL, и по масштабам она, кстати, заметно выросла (в этом году организаторы получили 17 669 заявок против 8 тысяч в прошлом).
В этом году на EMNLP особенно актуальна тема бенчмарков. Старые насыщаются с огромной скоростью, и индустрия остро нуждается в свежих методах эвала LLM.
Один из трендов – игровые бенчи. Игры дают то, чего статичным наборам не хватает, а именно: проверяют стратегическое мышление, удержание контекста и умение мыслить многошагово.
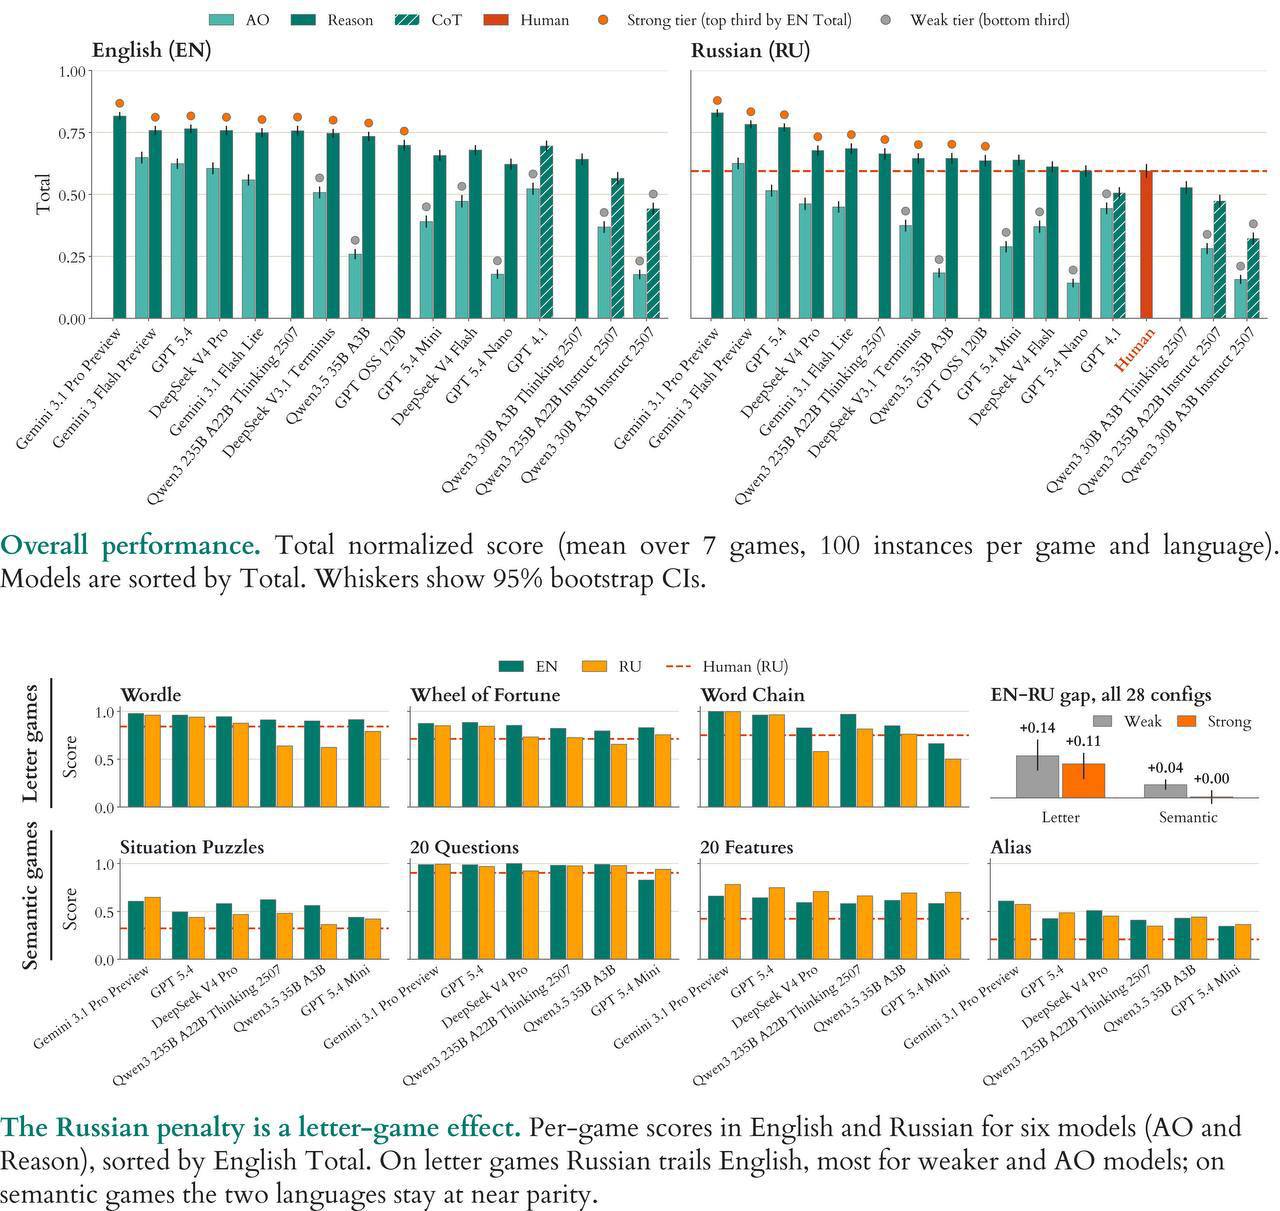
MTGBench – это как раз игровой двуязычный бенчмарк, который состоит из семи многоходовых игр, каждая на английском и русском языках, куда входят Wordle, «Цепочка слов», «Данетки», «20 вопросов», «Поле чудес», «20 признаков» и «Алиас».
Кроме наполнения, бенчмарк интересен тем, на все ходы модели можно объективно ответить. В четырех играх результат проверяет алгоритм, в трех остальных LLM-судья строго ограниченно следит за соблюдением правил. Сам судья отдельно независимо провалидирован.
Лидерборд по 16 протестированным моделям наверху. Сильные ризонинг-модели догоняют или обгоняют собранный авторами человеческий бейзлайн за счет эффективной игры и получения отгадки за меньшее число ходов 😐
Вторая статья посвящена оценке машинного перевода. Его качество растет, но ошибки в передаче смысла и неестественные формулировки по-прежнему встречаются и не всегда заметны при первом чтении. Их поиск требует внимательной работы подготовленных экспертов, а такую разметку сложно масштабировать. Авторы исследовали, могут ли языковые модели оценивать перевод на экспертном уровне, и как должен быть устроен такой оценщик.
Для исследования собрали 600 англо-русских переводов с тремя независимыми экспертными разметками каждого и последовательно проверили влияние инструкций, способов подготовки и отбора примеров, выбора моделей и объединения их отчетов. Итогом стало семейство оценщиков ORBIT. Лучшая конфигурация достигла экспертного уровня согласованности в поиске ошибок при стоимости примерно в 28 раз ниже одного прохода профессионального эксперта. Подход также проверили на пяти других языковых направлениях с независимой разметкой по протоколам MQM и ESA.
Поздравляем исследователей с отличной работой и публикациями на EMNLP!
Кратко (AI)
Исследователи из Яндекса опубликовали на EMNLP 2026 две работы: о двуязычном игровом бенчмарке MTGBench для оценки LLM и о семействе оценщиков качества перевода ORBIT. Лучшая конфигурация ORBIT достигла экспертного уровня согласованности при стоимости примерно в 28 раз ниже одного прохода профессионального эксперта.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖