MTGBench проверяет, как модели справляются с уточнениями запросов
М@cgeventAI-инженер
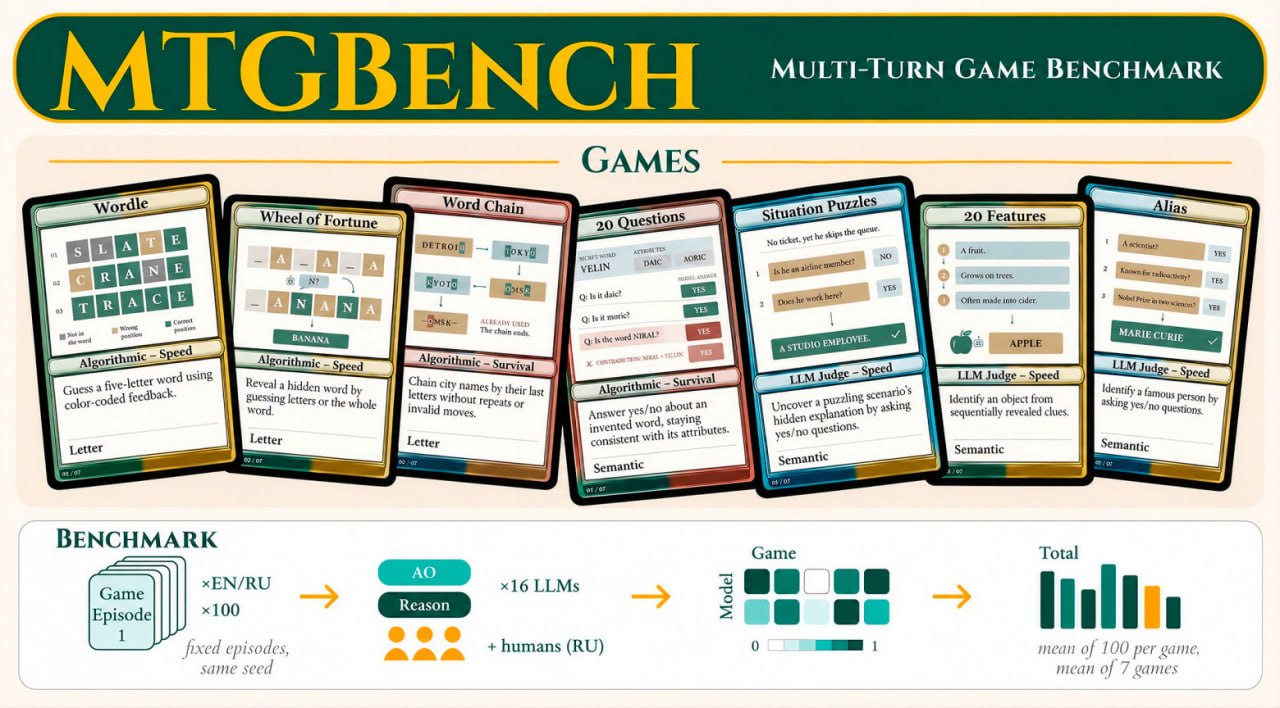
1 чСтуденты ШАДа и Яндекс выпустили открытый бенчмарк MTGBench: он проверяет, как 16 моделей справляются с уточнениями запросов на русском и английском.
Бенчмарк помогает понять, когда модели теряют смысл диалога и тратят токены без пользы.
- Разработчики могут проверить, как модель реагирует на меняющиеся условия запроса.
- Открытые код и данные позволяют повторить оценку.
- Результаты показывают, что качество на одной задаче не гарантирует качества на другой.
Студенты ШАДа и Яндекс бахнули в опенсорс бенчмарк, который помогает понять, где пользователи жгут токены впустую
MTGBench проверяет, не теряет ли модель нить, когда запрос уточняется по ходу. Например, когда сперва пишете «спланируй поездку», потом уточняете бюджет, потом меняете даты и т.д. Внутри семь текстовых игр для моделек, на русском и английском.
Что в итоге (прогнали 16 моделей):
• Умные режимы помогают не везде. На задачах про знания и смыслы прирост скромный.
• Крутой результат в одной задаче ничего не гарантирует в другой.
• По-русски модели тупят сильнее, особенно с буквами. Но это мы и так знали.
Кому встраивать ИИ в продукт, тот может заранее проверить, где длинные рассуждения окупаются. Статью взяли в Findings EMNLP 2026, код и данные открыты.
https://github.com/skyberg11/MTGBench
https://aclanthology.org/2026.findings-emnlp.1333
@cgevent
Кратко (AI)
Студенты ШАДа и Яндекс представили открытый бенчмарк MTGBench для проверки того, как модели удерживают контекст при последовательных уточнениях запроса. В тестах 16 моделей показали, что результаты зависят от задачи, а на русском языке модели справляются хуже; статья принята в Findings EMNLP 2026.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖