OpenBMB и Baidu представили новые OCR-модели
Н@GreenNeuralRobotsAI-инженер
1 чMiniCPM OCR предлагает две модели для распознавания документов, а Unlimited-OCR 2 от Baidu обрабатывает многостраничные материалы с ускоренным декодированием.
Новые модели нацелены на более быстрое распознавание длинных и сложных документов.
- Unlimited-OCR 2 обрабатывает многостраничные документы с рабочей памятью на 512 опорных токенов.
- Для отдельных шагов декодирования на сотне страниц заявлено ускорение до 7 раз.
- Лицензия MIT разрешает коммерческое использование Unlimited-OCR 2.
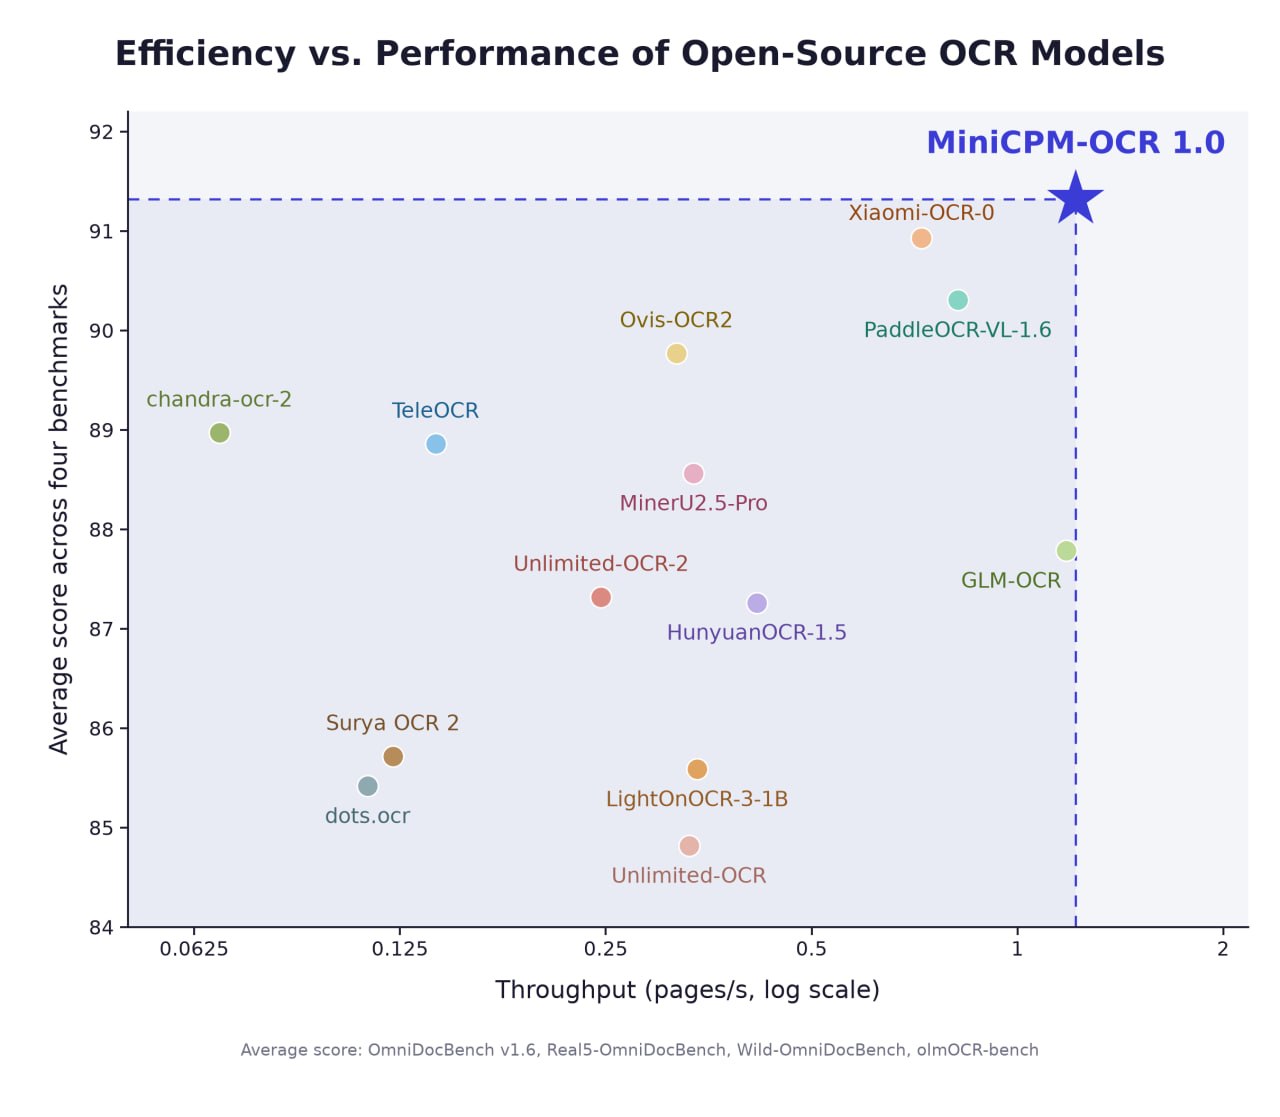
MiniCPM OCR
Первый #OCR от OpenBMB, две модели под разные задачи.
• 1.0 на 1.3B: сложные верстки, таблицы, формулы
• DSpark дает на 55% больше пропускной способности
• Jev на 2 млрд проверяет точность распознавания, в том числе чужого
• 0,936 AUROC на JevOCRBench, помечает сомнительные места для ручной проверки
———
Unlimited-OCR 2
Распознавание документов почти любой длины от Baidu, около 3 млрд параметров.
• Сканы, PDF, многостраничные материалы, таблицы и формулы
• Механизм SR-SWA: модель смотрит текущую страницу и горстку нужных фрагментов, а не весь документ
• Рабочая память на 512 опорных токенов, цена шага почти не растет с длиной
• На сотне страниц отдельные шаги декодирования до 7 раз быстрее полного внимания и до 5,6 раза быстрее прошлой версии
• Страницы идут перекрывающимися блоками, память освобождается по ходу
• Лицензия MIT, включая коммерцию
github.com/baidu/Unlimited-OCR
huggingface.co/baidu/Unlimited-OCR-2
Кратко (AI)
OpenBMB представила MiniCPM OCR: модель 1.0 на 1.3B рассчитана на сложную верстку, таблицы и формулы; также упомянуты DSpark и проверка распознавания на JevOCRBench. Baidu выпустила Unlimited-OCR 2 примерно с 3 млрд параметров для документов почти любой длины; пост отмечает ускорение отдельных шагов декодирования и лицензию MIT.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖