Выход UltraBERT: новые открытые энкодеры с контекстом 32K
M@machinelearning_interviewAI-инженер
1 недПредставлены модели UltraBERT на 152M и 380M параметров. Исследование показывает, что стратегия обучения важнее масштабирования данных.
Новый подход к обучению моделей позволяет достигать высокой точности при меньших вычислительных затратах.
- Модели UltraBERT эффективнее справляются с классификацией и поиском, чем предыдущие аналоги.
- Исследование подтверждает, что бесконечное увеличение данных не всегда ведет к росту качества на прикладных задачах.
- Разработчики получили компактные и мощные инструменты для NLP-задач с лицензией Apache 2.0.
🧠 BERT жив. UltraBERT показал, что рецепт обучения может быть важнее дополнительных триллионов токенов.
Вышли открытые энкодеры на 152 млн и 380 млн параметров с контекстом 32K. Для классификации текста, распознавания сущностей, поиска ответов, оценки качества и retrieval.
Главная фишка обучения:
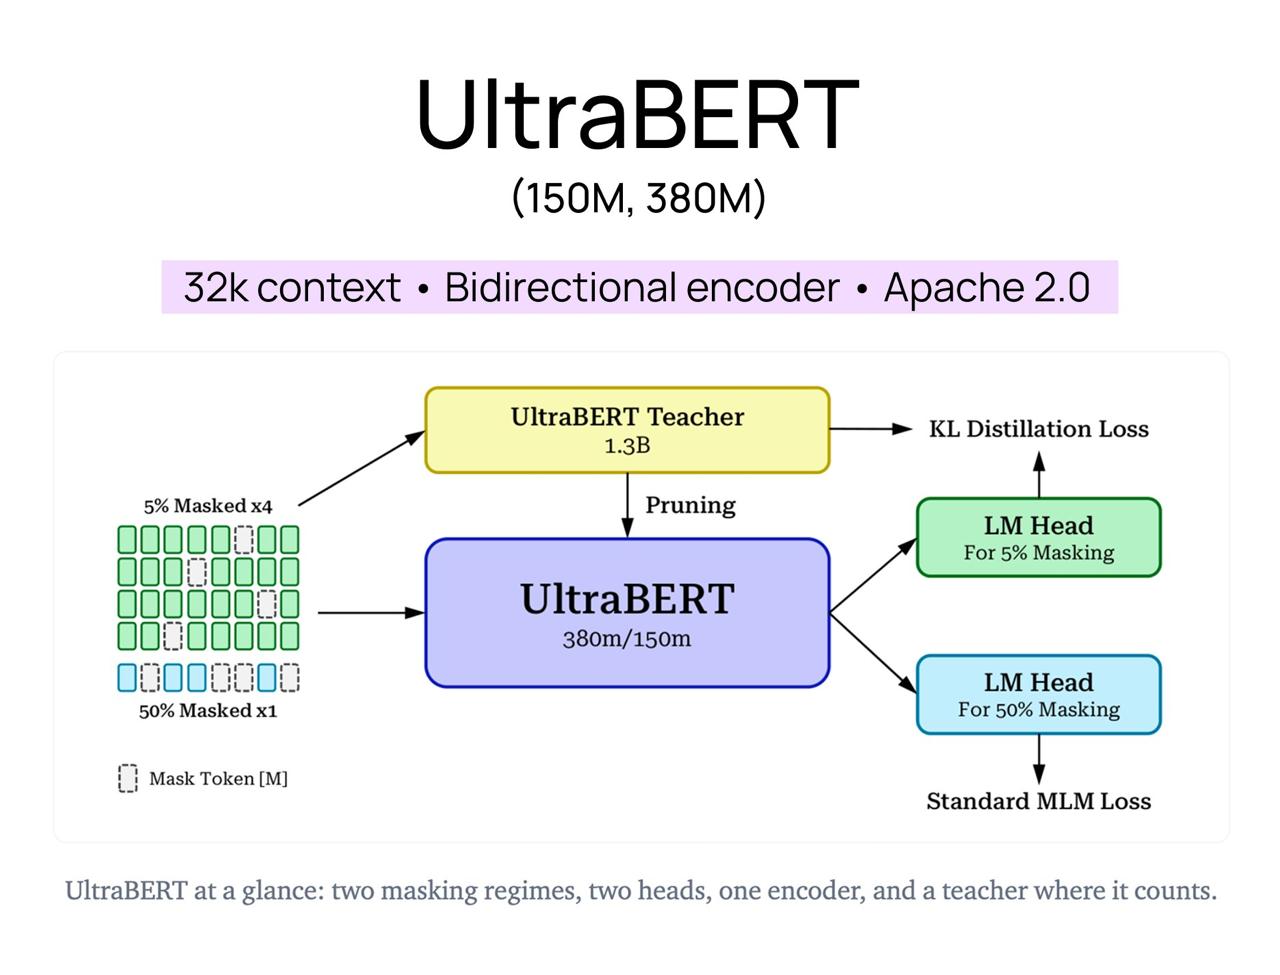
• В одних примерах скрывают 5% токенов: это помогает классификации.
• В других скрывают 50%: это помогает поиску.
• Для каждого режима используют отдельную выходную голову.
• Знания модели-учителя на 1,3 млрд параметров передают только примерам с 5% маскирования.
Почему выборочно? В экспериментах дистилляция улучшала классификацию, но ухудшала поиск при высоком маскировании. Универсального «учитель всегда делает ученика лучше» не получилось.
Ещё один показательный вывод: после 1–2 трлн токенов качество на прикладных задачах выходило на плато, хотя loss продолжал снижаться.
По сравнению авторов, версия 380M лидирует на GLUE и BEIR среди сопоставимых энкодеров. Младшая модель достигает уровня RoBERTa-large в классификации при 2,3 раза меньшем числе параметров.
Веса, код и лицензия Apache 2.0:
https://huggingface.co/collections/dmis-lab/ultrabert
Статья:
https://arxiv.org/abs/2610.15028
Кратко (AI)
Исследователи представили UltraBERT — новые открытые энкодеры, которые доказывают, что методы обучения могут быть эффективнее простого увеличения объема данных. Модели используют разные стратегии маскирования токенов для различных задач, что позволяет им превосходить аналоги при меньшем количестве параметров.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖