Запуск LLM на 120 млрд параметров на кластере из потребительских устройств
P@prohitecавтор про «tech»
1 недЭнтузиаст запустил квантованную модель gpt-oss-120b на шести разнородных устройствах, включая Galaxy S24+ и MacBook, используя пайплайн-параллелизм.
Этот эксперимент доказывает возможность запуска огромных нейросетей на обычном домашнем оборудовании.
- Показана возможность распределения весов нейросети между устройствами разного типа.
- Метод пайплайн-параллелизма позволяет обходить ограничения памяти отдельных видеокарт или ПК.
- Скорость работы пока остается крайне низкой для практического применения.
Модель на 120 млрд параметров запустили на распределенном кластере из шести потребительских устройств
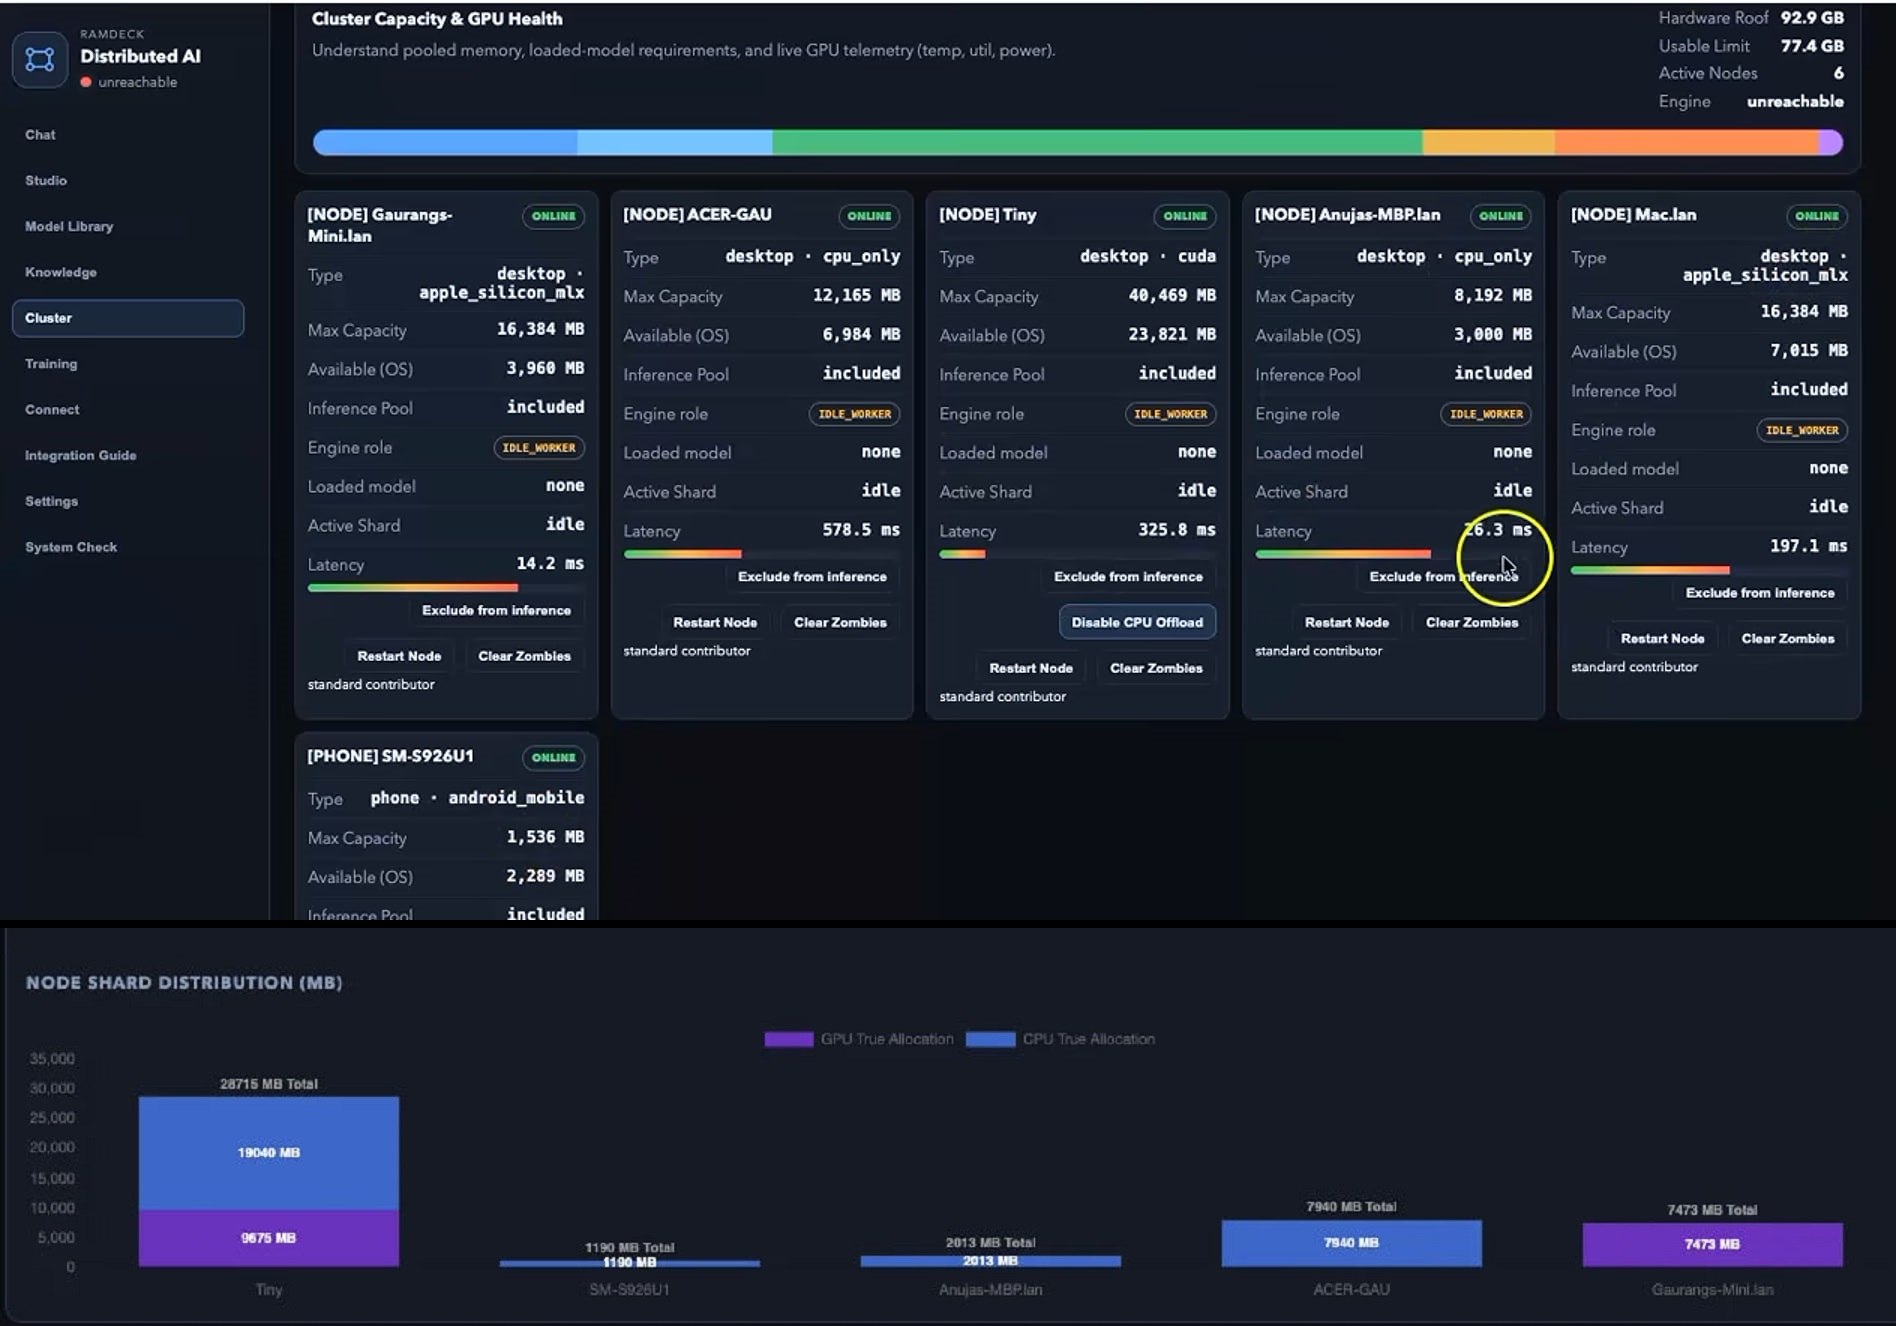
Реддитор объединил Galaxy S24+, ПК с RTX 3060 (12 ГБ), бюджетный Windows-ноутбук и три разных MacBook/Mac mini в единый вычислительный кластер. Система смогла загрузить 4-битную квантованную версию LLM-модели gpt-oss-120b, требующую минимум 47 ГБ памяти.
Технически запуск реализован через пайплайн-параллелизм (pipeline parallelism). Вместо полной загрузки весов на одно устройство слои нейросети были последовательно нарезаны и распределены между шестью узлами по локальной сети. Основную нагрузку взял на себя рабочий ПК, предоставивший 28.7 ГБ ОЗУ и ресурсы RTX 3060. Из-за задержек межпроцессного взаимодействия и разнородного железа скорость генерации составила всего 1.1 токена в секунду, что делает проект скорее доказательством концепции, чем практическим инструментом.
Кратко (AI)
Энтузиаст с Reddit объединил шесть различных потребительских устройств в единый кластер для запуска LLM-модели gpt-oss-120b. Благодаря использованию пайплайн-параллелизма, модель была распределена по узлам, однако из-за задержек сети и неоднородности железа скорость генерации составила всего 1.1 токена в секунду.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖