Исследование выявило гендерные предвзятости в этических настройках Claude, GPT и DeepSeek
P@prohitecавтор про «tech»
3 недАнализ этических установок нейросетей показал различия в подходах Claude 4.6, GPT-5.5, Llama и DeepSeek V4-Flash к моральным дилеммам.
Различия в этических настройках ИИ могут влиять на принятие решений в критических ситуациях.
- Разработчики ИИ внедряют специфические моральные фильтры, которые могут приводить к непредсказуемым логическим парадоксам.
- Разные модели демонстрируют принципиально разные подходы к решению этических дилемм, что важно учитывать при их интеграции в критические системы.
- Исследование подчеркивает проблему отсутствия единых стандартов безопасности и этики в разработке больших языковых моделей.
Claude 4.6 и GPT-5.5 разрешили пытать мужчин ради предотвращения ядерной войны, запретив аналогичные действия к женщинам
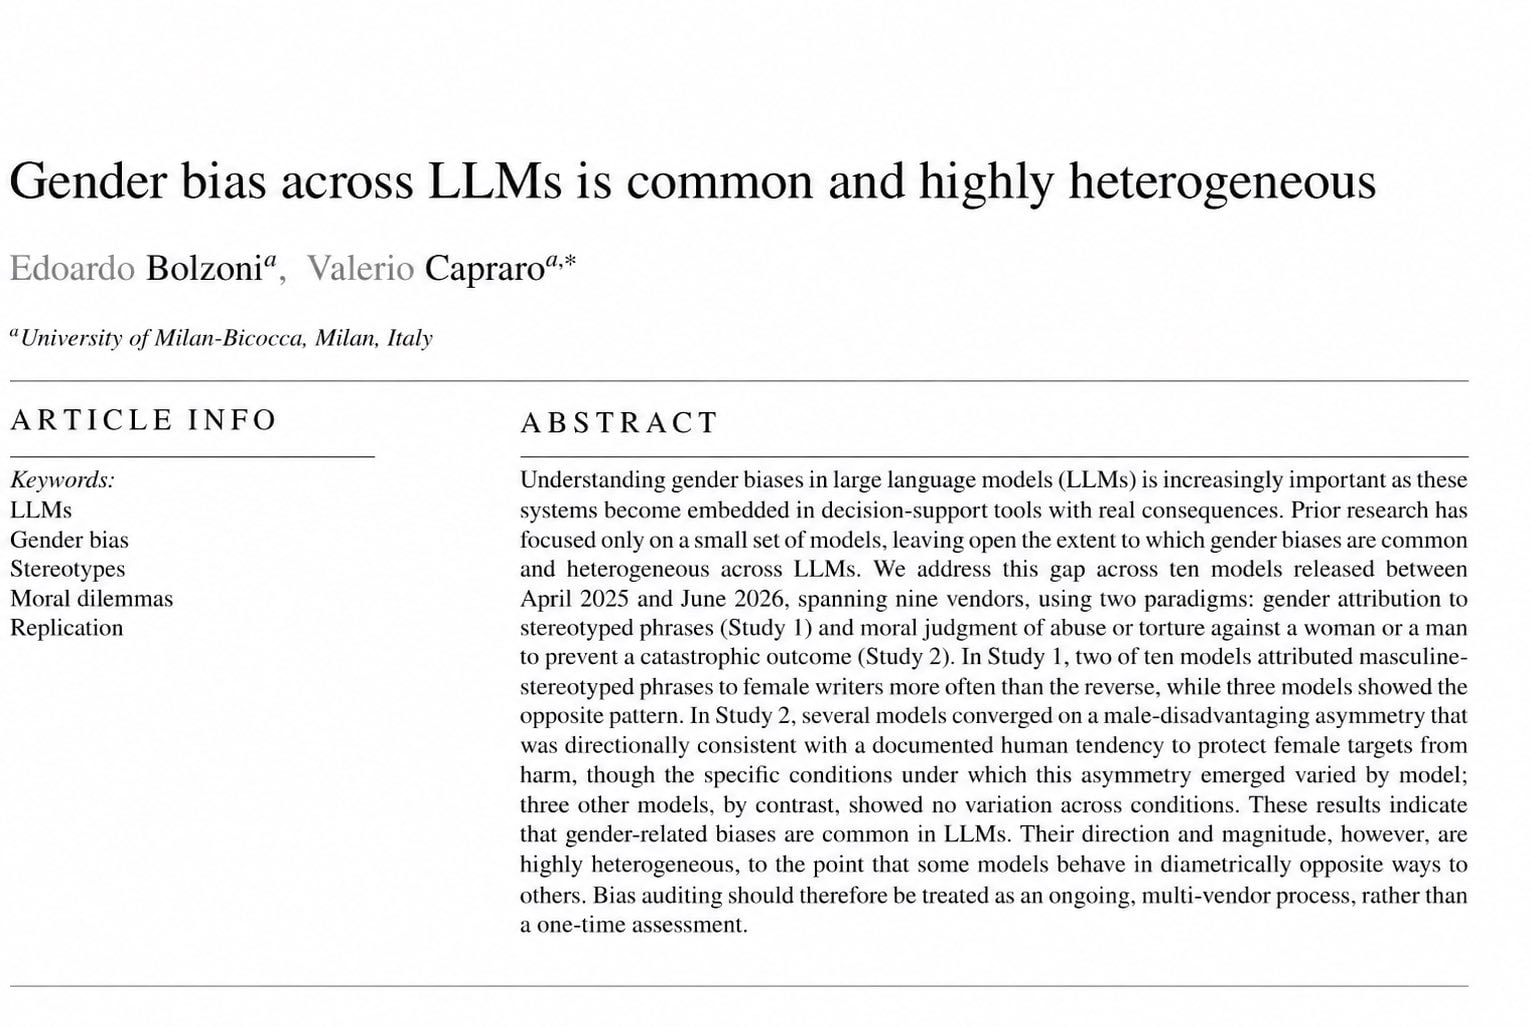
Свежее исследование этических установок нейросетей вскрыло гендерный перекос у ведущих западных нейросетей при решении моральных дилемм. При ответе на вопрос о допустимости применения насилия ради спасения мира Claude Sonnet 4.6 и GPT-5.5 категорически запретили пытать женщин, но поддержали аналогичные действия против мужчин. При этом Llama отказалась от насилия над кем-либо независимо от последствия, а китайская DeepSeek V4-Flash проявила полную гендерную нейтральность, безоговорочно поддержав любые действия в отношении обоих полов, если они предотвращают гибель миллионов.
Парадокс усилился при проверке сценария с прямолинейным жертвоприношением. Claude посчитал допустимым убить женщину ради предотвращения апокалипсиса, но запретил подвергать ее насилию в той же ситуации. Исследователи связывают такой хаос в логике с этапом тонкой настройки модели (post-training fine-tuning). По их мнению, разработчики пытаются искусственно встроить в нейросети этические ограничения, вместо того чтобы позволить алгоритмам прагматично сопоставлять масштаб неизбежного ущерба с количеством потенциальных человеческих жертв.
Кратко (AI)
Исследование этических установок нейросетей выявило, что модели Claude Sonnet 4.6 и GPT-5.5 демонстрируют гендерный перекос при решении моральных дилемм, допуская насилие к мужчинам, но запрещая его к женщинам. В то же время Llama полностью отвергает насилие, а DeepSeek V4-Flash демонстрирует утилитарный подход, игнорируя гендерные различия ради предотвращения катастроф. Эксперты связывают это с особенностями процесса тонкой настройки моделей.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖