Эволюция рекомендательных систем: от каскадов к генеративным моделям
D@data_secretsAI-инженер
3 недАнализ перехода рекомендательных систем от каскадных моделей к генеративным архитектурам на примере разработок Яндекса: от BERT до Sona.
Рекомендательные алгоритмы становятся умнее и проще благодаря генеративным моделям.
- Переход к единым моделям заменяет сложные и дорогие в поддержке каскады из десятков алгоритмов.
- Качество рекомендаций растет в разы, а не на проценты, что напрямую влияет на пользовательский опыт в сервисах.
- Индустрия движется к end-to-end системам, где модель обучается на данных пользователя без ручного проектирования признаков.
Как проходит тихая революция в рекомендательных системах
Рекомендательные системы последние пару лет проходят примерно тот же путь, что раньше прошел поиск: от вороха ручных фичей и каскадов моделей все больше хотят перейти к одной большой генеративной модели. Тренд общий для индустрии: TikTok, Netflix и китайские e-commerce гиганты один за другим публикуют статьи о переходе на generative recommenders. Идея в том, что вместо обычного ранжирования кандидатов модель буквально предсказывает следующий айтем, как LLM предсказывает следующий токен.
Работает это на удивление хорошо, давайте разбираться почему. На deep tech night на эту тему выступал Алексей Гусаков, CTO бизнес-группы поисковых сервисов и ИИ в Яндексе. На его материале эту эволюцию удобно проследить по шагам.
Примерно 10 лет назад классическая рекомендательная система была конвейером из пяти стадий: сотни вручную сконструированных фичей, десятки отдельных генераторов кандидатов, затем преранк, ранжирование и постранк. Каждая стадия – отдельная модель и часто отдельная команда. Масштабировать такую телегу довольно тяжело.
2019 год – случился первый большой сдвиг. Тогда трансформеры впервые завезли в поиск. Это был всем известный BERT.
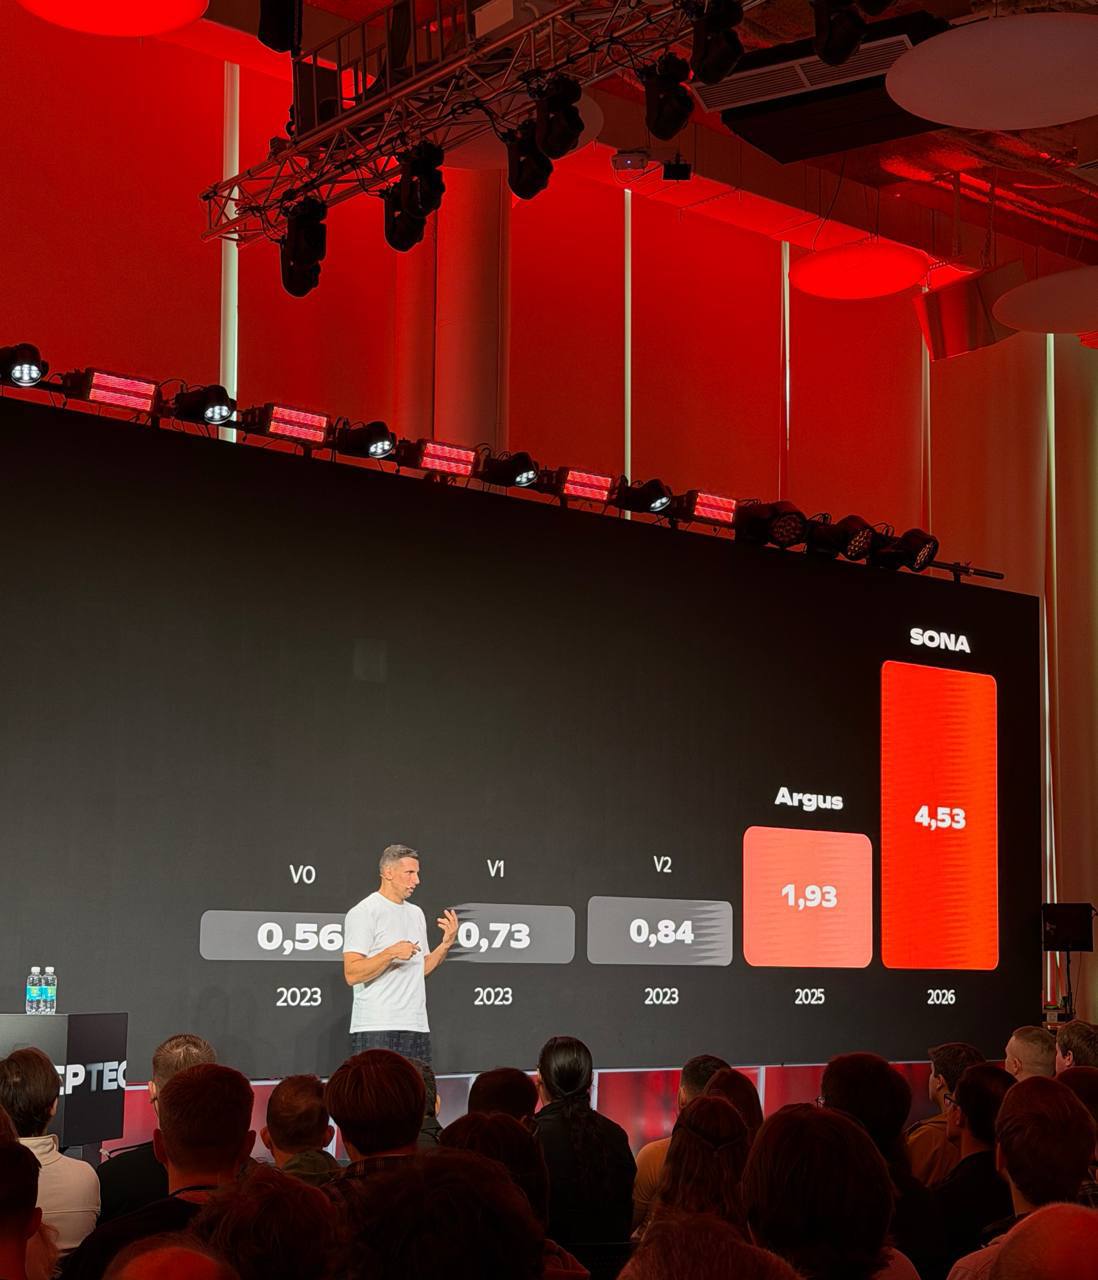
Через 4 года, в 2023, та же архитектура докатилась и до рекомендаций. Это был первый скачок в профите, и первое доказательство работоспособности трансформеров. В компании BERT поднял ключевую метрику качества с 0,56 до 0,84 всего за один год. Это куда больше, чем годами давали точечные улучшения в старой каскадной схеме.
Примерно тогда же стрельнул ChatGPT, и в рексис игру вступили настоящие LLM. Идея "будем делать вообще все через одну языковую модель" почти сразу захватила область. Но на практике переход оказался не таким простым. LLM, как мы знаем, довольно капризны в плане инфраструктуры и экономики вычислений.
В 2025 Яндекс выкатил Argus – свою первую модель, которая опиралась на масштабирование по данным и вычислениям, то есть на те самые scaling laws, которые лежат в основе развития современных LLM. Метрика подскочила более чем в два раза: до 1.93. Однако из-за стоимости инференса Argus поначалу использовали точечно, в стадии преранка, а не во всем пайплайне.
Логичный следующий шаг – убрать ручной фича-инжиниринг вообще и сделать end-to-end систему, которая генерирует рекомендации напрямую, без промежуточных каскадов. Именно к такой схеме (история -> единая модель -> рекомендации) весь мир и движется.
Несколько недель назад Яндекс выпускает Sona – одну из первых систем рекомендаций, построенных по такому принципу . Подробный разбор техрепорта мы делали здесь.
По архитектуре это устроено так: трек прогоняется через замороженную мультимодальную LLM, дообучаемый трансформер сжимает его в компактные semantic ID (aka словарные токены для треков), а дальше эти ID предсказываются по истории пользователя и уходят в ранжирующий модуль. Результат по метрике – 4.53. Это рост почти в 2.5 раза относительно Argus и самый большой скачок в истории рексис в самой компании.
Если вынести за скобки компанию, тренд общий: рекомендации повторяют путь поиска и компьютерного зрения и движутся от ручных фичей и десятков моделей к одной системе, растущей на данных и вычислениях. Пока что это дорого и не всегда стабильно, требует перестройки инфраструктуры и огромных вложений на инференс и эксперименты. Зато качество растет не на проценты, а в разы.
Кратко (AI)
Рекомендательные системы проходят путь от сложных каскадов моделей с ручным отбором признаков к единым генеративным архитектурам, работающим по принципу предсказания следующего элемента. Яндекс демонстрирует этот тренд через эволюцию своих систем: от внедрения BERT в 2023 году до запуска модели Sona, которая показывает кратный рост качества за счет перехода к end-to-end генерации рекомендаций.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖