Scaling Laws for Looped Mixture of Experts
К@quant_prune_distillAI-инженер
3 недИсследование законов масштабирования для архитектур Looped Mixture of Experts, оптимизирующих разреженность и число рекурсий при заданном бюджете.
Исследование помогает эффективнее обучать сложные нейросетевые архитектуры с ограниченными ресурсами.
- Позволяет точнее подбирать параметры разреженности и глубины рекурсии.
- Оптимизирует использование вычислительных мощностей при обучении MoE-моделей.
- Предлагает теоретическую базу для масштабирования новых типов архитектур.
Scaling Laws for Looped Mixture of Experts
📄 Статья
Есть MoE, которые как-то скейлятся (по разреженности / гранулярности).
Есть Looped-модели, где несколько прогонов дают качество потенциально выше, чем однократный прогон.
И для них по отдельности есть свои законы масштабирования.
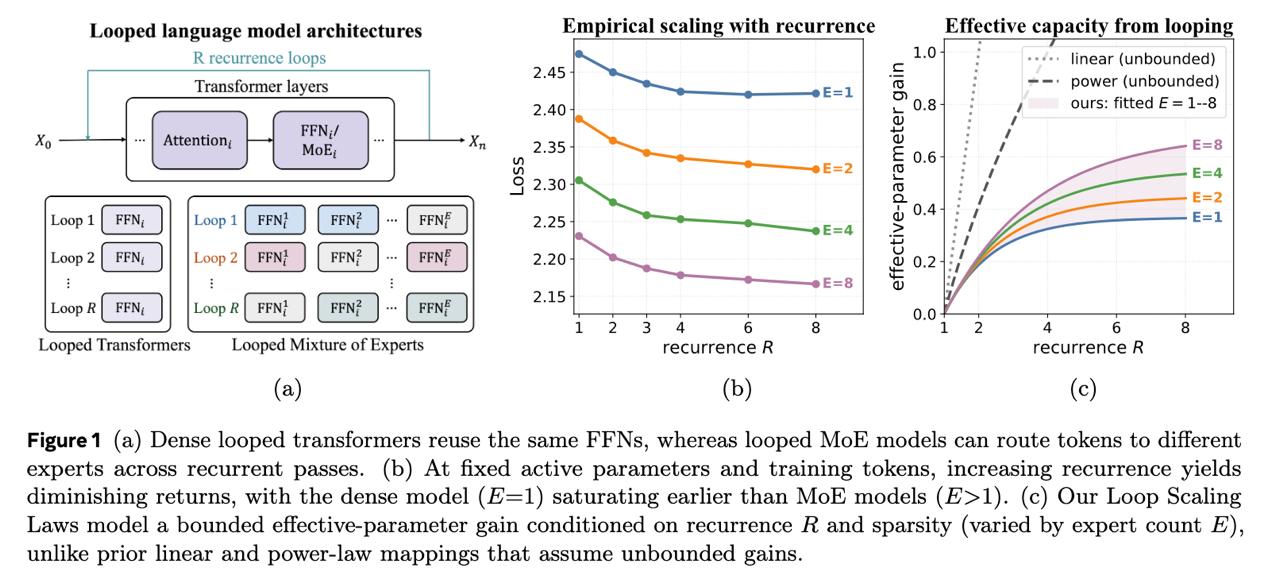
Но если мы хотим Looped MoE, то как скейлить разреженность и число рекурсий?
И данная работа подбирает некий анзатц, который неплохо согласуется с экспериментом, и выводит правила оптимального масштабирования при заданном размере модели и вычислительном бюджете на обучении.
Кратко (AI)
В статье исследуются законы масштабирования для архитектур Looped Mixture of Experts (MoE). Авторы выводят математический анзатц, который позволяет определять оптимальное соотношение между разреженностью модели и количеством рекурсивных прогонов при фиксированном вычислительном бюджете.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖