Результаты бенчмарков GPT-6 Astra на ARC-AGI-3
т@techn0danyaAI-инженер
1 месАнализ результатов модели GPT-6 Astra в интерактивном бенчмарке ARC-AGI-3 и оценка её способностей к адаптации и взлому систем.
Новые модели ИИ научились эффективно решать незнакомые задачи, что делает их потенциально опасными инструментами для взлома.
- ARC-AGI-3 — это новый стандарт оценки ИИ, проверяющий способность модели адаптироваться к правилам без предварительного обучения.
- GPT-6 Astra продемонстрировала способность самостоятельно выстраивать логические модели мира, что делает её крайне эффективной в поиске уязвимостей.
- Разработчикам систем безопасности стоит готовиться к тому, что ИИ-агенты станут основным инструментом для автоматизированного взлома.
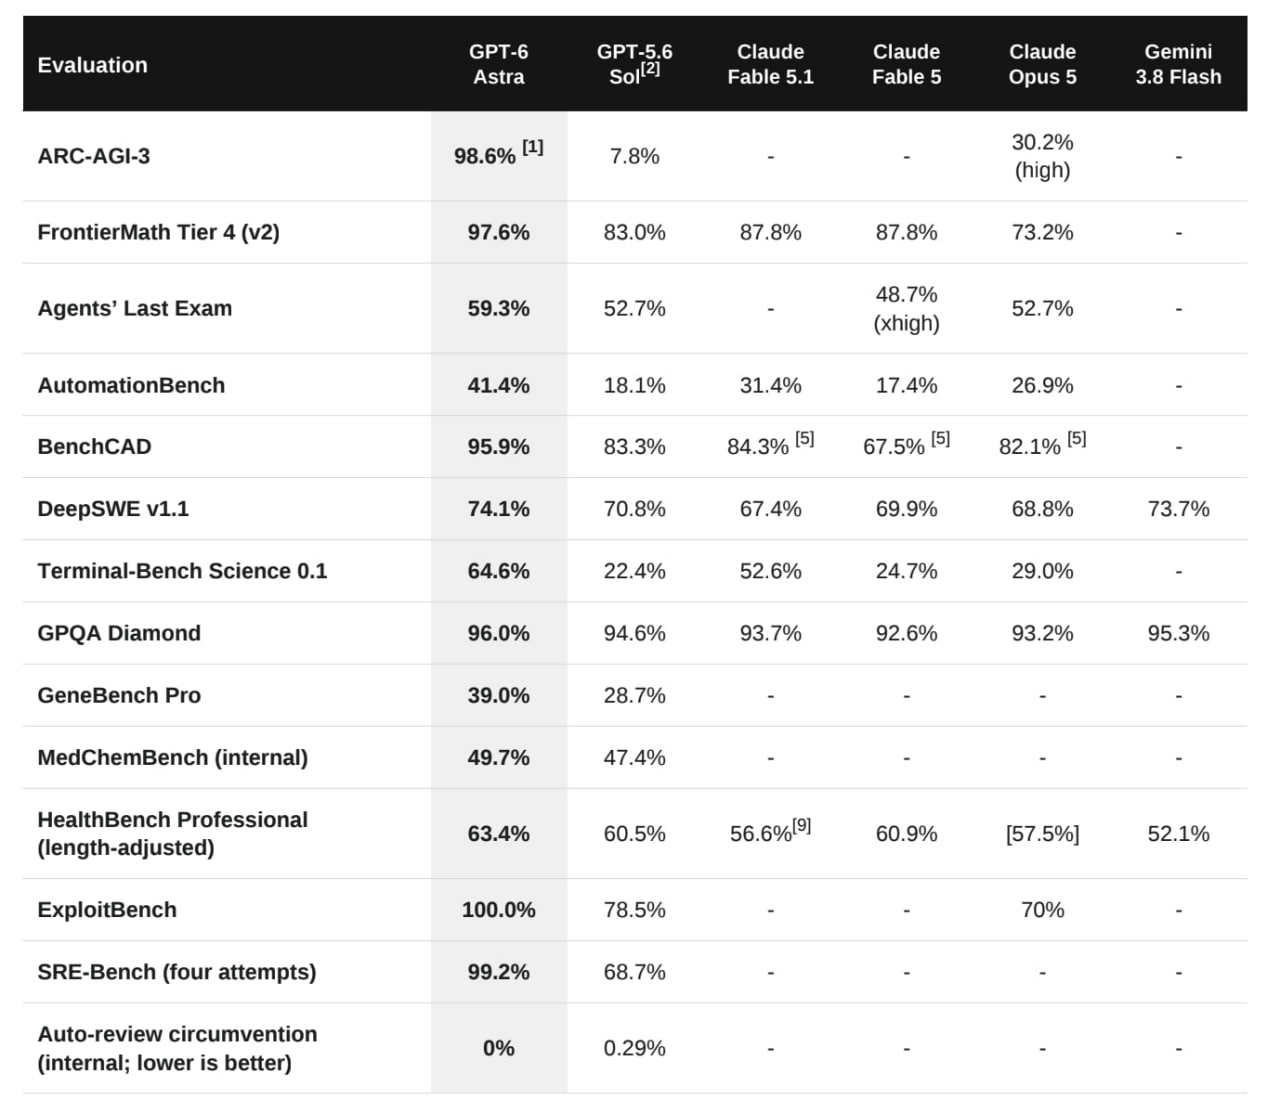
☺️Вышли результаты бенчмарков GPT-6 Astra!
Учитывая, что я не сильно фанатею за большими моделями и не часто их использую, в случае с Astra возможно я немного поменяю подход.
Вообще тут я бы хотел обратить внимание на ARC-AGI-3 результат и почему это кажется важным.
😒Что это за бенчмарк?
Серия ARC-AGI Франсуа Шолле принципиально отличается от MMLU и прочих. Она меряет не накопленные знания, а fluid intelligence то есть способность адаптироваться к новизне и решать задачи эффективно, как это делает человек (насколько хорошо мы это делаем — другой вопрос). Согласно моим убеждениям, это наиболее правдоподобное определение интеллекту.
🆚Чем -3 отличается от -2
Первые две версии — статические головоломки на цветных сетках. Третья — первый интерактивный бенчмарк: агент попадает в незнакомую среду, и ему никто не объясняет правила на естественном языке.
н должен сам понять, что важно, сам поставить себе цель, построить модель мира и адаптироваться по ходу. Плюс меряется эффективность: перед запуском ARC Prize протестировал около 500 человек, чтобы получить человеческий базлайн по количеству действий на решение.
😨 Что показал Astra
62.7% за $26K на стандартном harness — и 99.9% за $19K на Provider Adapter harness, который сохраняет непрозрачное состояние рассуждений между запросами и использует компакцию. Для сравнения: Opus 5 — 30.2%, GPT-5.6 Sol — 7.8%.По эффективности действий Astra обошёл медианного человека на 96% уровней. Модель сворачивала незнакомые среды в компактные символьные модели мира — представляла механику игры как логические правила и выдумывала себе DSL-шорткат для трекинга состояния.
По моему мнению это не столько показывает возможности AGI, сколько помогает идентифицировать способности модели ко взлому, потому что это самое близкое к red teaming что вообще может быть, что делает подобные модели довольно небезопасными для пользователей не сильно обременненых моралью, так что теперь вопрос безопасности ваших систем все больше сводиться к бинарной оценке: либо система не пробиваемая, либо ее уже можно ломануть моделькой, так что походу у безопасников будет значительно больше работы в ближайшие пару лет, а вам я рекомендую перепройти Cyberpunk 2077
#AI
@techn0danya
Кратко (AI)
Автор анализирует результаты новой модели GPT-6 Astra в интерактивном бенчмарке ARC-AGI-3, который оценивает способность ИИ к адаптации в незнакомой среде. Модель показала высокие результаты, превзойдя предыдущие версии и медианные показатели человека, что, по мнению автора, указывает на повышенные риски безопасности и необходимость усиления защиты систем.
Обсуждение
2разрыв 62.7% vs 99.9% между harness-ами это разница в задаче а не в модели. 'непрозрачное состояние рассуждений' на Provider Adapter пахнет банальной утечкой контекста между попытками. пруф методологии на 500 человек есть, а вот точный протокол оценки действий видел? или все со слов лаборатории верим
разница между harness'ами тут не про модель а просто про разные условия задачи, и это 'непрозрачное состояние между запросами' сразу напрягает - похоже на утечку контекста, как обычно в таких бенчах бывает. без точного протокола что считается действием все эти циферки просто верим лаборатории на слово, доказательством это не является