generation_mode="editing" самой LLaDA-Image.
Тестируем:
ComfyUI + quantized weights:
https://huggingface.co/realrebelai/LLaDa-Image-Turbo_ComfyUI
ComfyUI nodes:
https://github.com/RealRebelAI/LLaDa-Image_ComfyUI
Официальные веса:
https://huggingface.co/inclusionAI/LLaDA-Image-Turbo
Официальный код:
https://github.com/inclusionAI/LLaDA-Image
При этом сама идея LLaDA началась вообще не с изображений.
В феврале 2025 года появилась оригинальная LLaDA — Large Language Diffusion with mAsking, я писал про нее, 8B языковая модель, построенная вокруг diffusion вместо классической autoregressive генерации. Модель генерирует текст через iterative denoising/masking, а не предсказывает следующий токен строго слева направо.
Затем появились LLaDA 1.5, LLaDA-V и другие работы, развивающие diffusion language models.
И получается интересная траектория:
Text Diffusion → Vision-Language Diffusion → Image Generation + Editing
Возможно, самое интересное в LLaDA-Image - не очередной benchmark, а сама попытка построить более единую diffusion-парадигму, которая начинается с текста и постепенно распространяется на мультимодальные задачи.
Оригинальная LLaDA — Text Diffusion:
https://github.com/ML-GSAI/LLaDA
https://arxiv.org/abs/2502.09992
LLaDA 1.5:
https://arxiv.org/abs/2505.19223
LLaDA-Image:
https://arxiv.org/abs/2609.03796
@cgeventВыход LLaDA-Image: диффузионная модель для генерации и редактирования изображений
М@cgeventAI-инженер
1 месinclusionAI представила LLaDA-Image — модель на базе Diffusion Transformer для генерации и редактирования изображений с поддержкой ComfyUI.
Появление новых архитектур генерации изображений, объединяющих разные задачи в одной модели.
- Единый чекпоинт для генерации и редактирования упрощает работу с нейросетями.
- Поддержка ComfyUI позволяет использовать модель локально на потребительском железе.
- Развитие диффузионных моделей для текста и изображений как единой парадигмы.
Вы будете смеяцца, но у нас новый генератор картинок.
Разбавим Астра-истерику.
LLaDA-Image: diffusion возвращается из текста в изображения
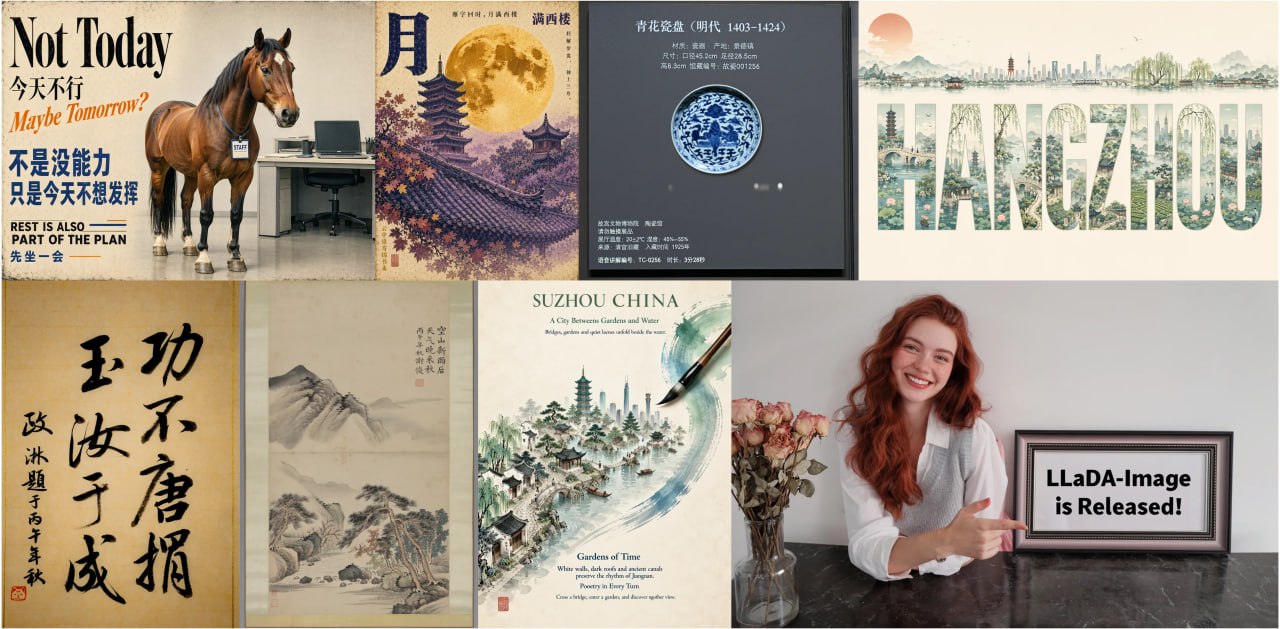
Сегодня inclusionAI выпустила LLaDA-Image - открытую модель для генерации и редактирования изображений, и это интересно своей историей.
LLaDA-Image — это 6B Diffusion Transformer, обученный с нуля, в связке с vision-language модулем на базе LLaDA2.0-Mini. В отличие от привычной схемы, где generation и editing реализованы разными моделями, здесь используется единый checkpoint для обеих задач.
Есть две версии:
LLaDA-Image — 50 шагов, ориентирована на максимальное качество.
LLaDA-Image-Turbo — distilled-версия, рассчитанная всего на 2–4 шага. Рекомендуемый режим — 4 steps и CFG 1.0.
И самое интересное для локального AI: ComfyUI уже здесь.
RealRebelAI выпустили отдельную сборку LLaDA-Image-Turbo для ComfyUI с:
— native INT8 Transformer в Safetensors
— Q4_K_M GGUF для text encoder
— поддержкой text-to-image
— native image editing
— собственными ComfyUI nodes
Причём editing работает не как обычный img2img с denoise strength: используется нативный режим
КонтекстAI
LLaDA (Large Language Diffusion with mAsking) — это архитектура языковых моделей, использующая диффузионный процесс вместо стандартной авторегрессии для генерации текста. LLaDA-Image является развитием этой концепции, перенося принципы диффузии из текстовых задач в область компьютерного зрения.
Кратко (AI)
Компания inclusionAI выпустила LLaDA-Image — модель на базе Diffusion Transformer, объединяющую генерацию и редактирование изображений в одном чекпоинте. Модель доступна в двух версиях, включая ускоренную Turbo-версию, и уже получила поддержку в ComfyUI благодаря сторонним сборкам от RealRebelAI.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖