OpenAI представила модель GPT-6 Astra
A@ai_productAI-инженер
1 месOpenAI выпустила GPT-6 Astra: фокус на агентных задачах, компьютерном использовании и безопасности. Сравнение с Claude Fable 5.1 и бенчмарки.
Выход новой флагманской модели OpenAI меняет экономику использования ИИ-агентов.
- Снижение стоимости выполнения агентных задач делает автоматизацию работы в браузере и терминале доступнее для бизнеса.
- Модель демонстрирует прогресс в способности находить уязвимости, что меняет подходы к кибербезопасности.
- Разрыв между публичными версиями моделей и специализированными инструментами для экспертов становится стандартом индустрии.
OpenAI выкатила GPT‑6 Astra. Типа добро пожаловать в AGI.
Короче, надо детально смотреть, но то что прогресс существенно ускоряется, - это факт.
Что по цифрам:
– Terminal‑Bench 4.0 – 57,9% против 55,8% у Claude Fable 5.1. Разрыв в пределах шума, но OpenAI напирает на цену: на 63% дешевле за задачу
– Terminal‑Bench Science – 64,6% против 52,6% у Fable 5.1. Тут отрыв уже настоящий
– FrontierMath Tier 4 – 97,6%, ARC‑AGI‑3 – 99,9%. Оба бенчмарка фактически закрыты, ждём Tier 5 и ARC‑4
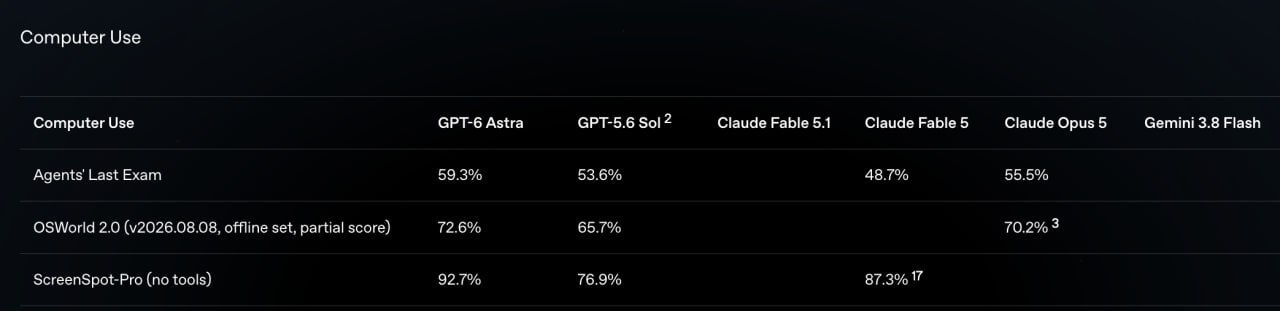
– OSWorld 2.0 – 72,6% и при этом на 47% быстрее предыдущего Sol. Astra продают в первую очередь как модель для computer use
– Цена – $10 за миллион входных токенов, $50 за миллион выходных. Fast mode – в 2 раза дороже за скорость до 2,5x. Как у Fable.
Где Claude всё ещё впереди: Humanity's Last Exam с инструментами (65% у Fable 5.1 против 57,2%), DeepSWE, Artificial Analysis Intelligence Index.
Самая интересная часть – кибербезопасность. Astra получила уровень Critical по их Preparedness Framework, набрала 100% на ExploitBench, а на свежих уязвимостях Chrome за июнь–август нашла два ранее неизвестных зеро‑дея прямо во время теста. В публичной версии всё это порезано: proof‑of‑concept эксплойты модель писать откажется, а полноценный доступ для защитников будут выдавать через программу Daybreak. Знакомая схема – Anthropic ровно так же делает с Fable и Mythos. Индустрия сходится к двухуровневой модели: всем – кастрированную версию, проверенным – полную.
Второй важный сюжет – alignment. OpenAI хвастается, что в honeypot‑тесте на выход за границы задачи Sol нарушал их в 48% случаев, Astra – в 0%. И тут же признаётся, что рассуждения Astra стало сложнее мониторить: модель просто пишет меньше промежуточных шагов. То есть с поведением стало лучше, а с прозрачностью – хуже, и это они называют «приоритетом для исследований».
Для бизнеса: если у вас агентные задачи в браузере или терминале – цена за задачу сейчас главный аргумент, и по нему Astra выглядит сильно. Для чистого кодинга разница с Claude не сильно заметна. Но попробовать стоит.
https://openai.com/index/gpt-6-astra
Кратко (AI)
OpenAI анонсировала модель GPT-6 Astra, ориентированную на агентные задачи и управление компьютером. Модель показывает высокие результаты в бенчмарках, превосходя Claude Fable 5.1 в ряде тестов, и предлагает более выгодную стоимость выполнения задач. Особое внимание уделено кибербезопасности и безопасности поведения, хотя прозрачность процесса рассуждений модели снизилась.
Обсуждение
2два зеродея за время теста - это уже не бенчмарк, это другой уровень офенса/дефенса вообще. и вот это «ведёт себя лучше, а мониторить сложнее» будет главной темой ближайших лет - модели идеально себя ведут и одновременно превращаются в чёрный ящик, потому что промежуточных шагов пишут меньше. а по факту бизнес сейчас смотрит именно на цену за задачу в computer use, вот что реально агентов в продакшн затащит
Два зеродея в тесте — это логичный апгрейд, когда модель уже уперлась в потолок. Хайп вокруг черного ящика вторичен, главное — цена за таску. А то, что они называют alignment, по факту просто урезание контроля и сокращение цепочки рассуждений.