NVIDIA ускорила локальный ИИ и представила инструмент PAIR
P@prohitecавтор про «tech»
1 месNVIDIA оптимизировала работу локальных ИИ-моделей на RTX и DGX, а также выпустила инструмент PAIR для распределения вычислений между устройствами.
NVIDIA делает запуск мощных ИИ-моделей на домашних компьютерах доступнее и быстрее.
- Ускорение работы локальных моделей позволяет запускать более сложные ИИ-агенты на обычном железе.
- Инструмент PAIR позволяет использовать простаивающие ресурсы других домашних устройств для вычислений.
- Оптимизация снижает порог входа для разработчиков и энтузиастов, работающих с локальными LLM.
NVIDIA ускорила локальный ИИ на картах RTX и станциях DGX, а также анонсировала инструмент PAIR
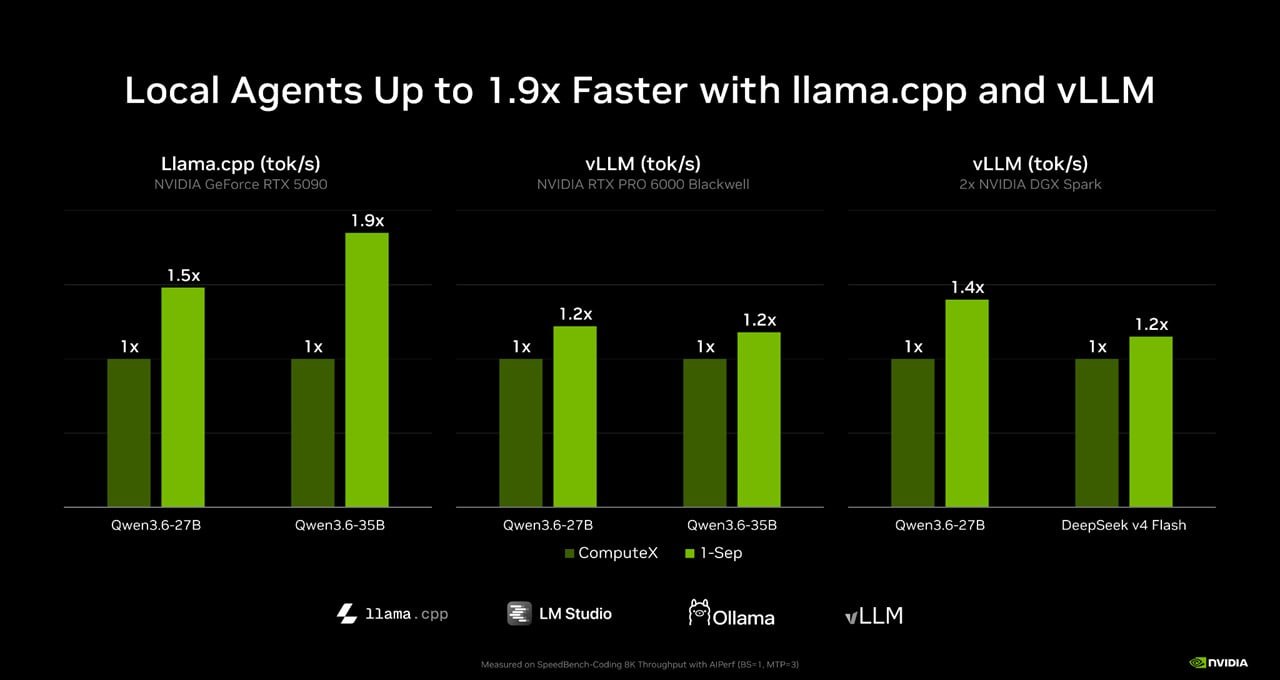
Компания NVIDIA выпустила масштабное обновление для локального ИИ, ускорив работу моделей на видеокартах RTX и станциях DGX. Совместные оптимизации с проектами llama.cpp и vLLM подняли производительность ИИ-агентов до 1,9 раза — к примеру, генерация ответов моделью Qwen3.6-35B на GeForce RTX 5090 выросла на 90%. Параллельно компания упростила запуск Hermes Agent и OpenClaw, добавив настройку «в один клик» для видеокарт с объемом памяти от 24 ГБ.
Вместе с этим представлен бесплатный открытый инструмент PAIR (Personal AI Router) для Windows, Linux и macOS. ПО объединяет домашние ПК и ноутбуки в единую сеть, перенаправляя запросы к Ollama и LM Studio на простаивающие устройства. Инструмент поддерживает любые графические чипы, включая встроенную графику сторонних производителей, и учитывает текущую нагрузку — если на ПК запущены игры, задача уйдет на другой узел. Это позволяет распределять вычисления между несколькими устройствами и ускорять сложные сценарии.
Кратко (AI)
NVIDIA выпустила обновление, которое значительно ускоряет работу локальных ИИ-моделей на видеокартах RTX и станциях DGX благодаря оптимизациям в llama.cpp и vLLM. Также представлен инструмент PAIR, позволяющий объединять несколько устройств в сеть для распределения вычислительной нагрузки при работе с Ollama и LM Studio.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖