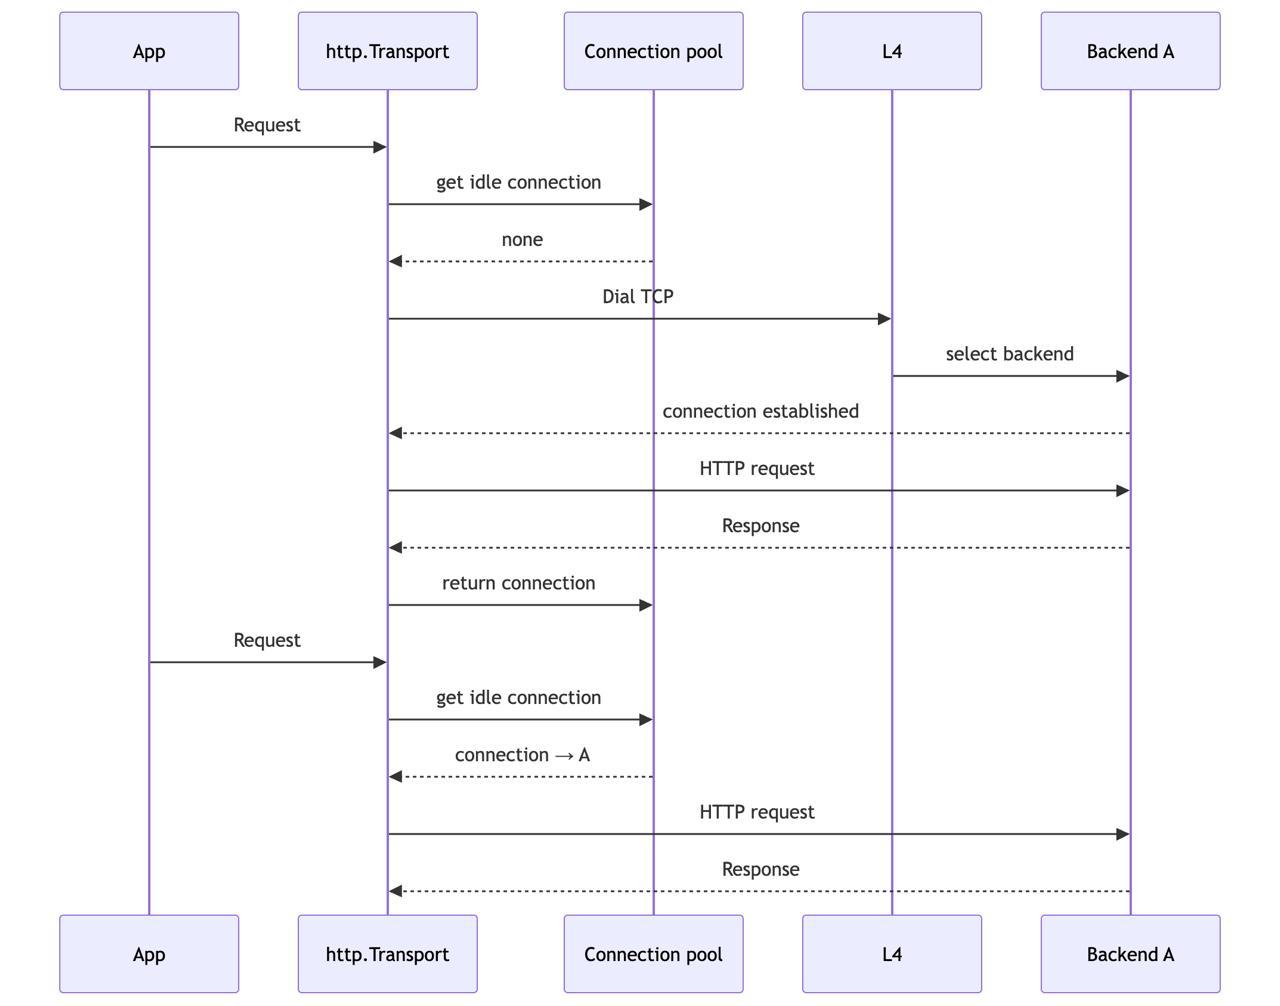
Причина перекосов в уровне балансировки
L4-балансировщик выбирает серверную ноду при создании соединения. Дальше http.Transport может переиспользовать это соединение через keep-alive, из за чего может случиться перекос нагрузки на одну ноду.
Проблема далеко не новая, но я хочу разобрать отдельные решения подробнее. В чем, собственно, проблема:
Для http 1.x свободные соединения в http.Transport переиспользуются по LIFO: логично, что нам выгоднее взять последнее освободившееся. Это видно в реализации
http.Transport.queueForIdleConn и в самой модели http.Transport:
type Transport struct {
    ///
 idleConn     map[connectMethodKey][]*persistConn // most recently used at end
    ///
В отдельных кейсах типо
#79664, LIFO может приводить к перекосу: если одна из нод отвечает немного медленнее остальных, её соединение позже возвращается в idle pool и оказывается последним использованным. Следующий запрос снова забирает его, нода опять отвечает дольше — и так по кругу. В данном кейсе мы минует L4 - ведь новых соединений нет и выбирать ему просто нечего.
Периодическая ротация соединений встряхнет L4 (рис 1)
В вышеописаном issue предлагают добавить новый параметр, который ограничит число запросов на одно соединение (MaxRequestsPerConn), чтобы они периодически закрывались и снова проходили через балансировщик. Например, можно периодически вытеснять активно переиспользуемые соединения через вероятностное включение Request.Close.
Подобную задачу давно решают на инфраструктурном уровне, например, в nginx есть upstream параметры keepalive_requests - которое ограничивает число запросов и keepalive_time типо время жизни соединения. Поэтому часть подобных проблем по 10+ лет не доезжает до http.Transport: их уже умеет решать инфра снаружи.
Балансировка на уровне пулов (рис 2,3)
Можно поступить грубее и держать несколько независимых http.Transport и распределяться между ними. Так устроен
clbtransport: снаружи это обертка, которая внутри ротирует запрос между несколькими пулами. Перед каждым запросом
сравнивается два кандидата: один по round-robin, второй рандомный. Запрос уходит в тот пул, где меньше незавершённых запросов на пул (это кстати Power of Two Choices).
К тому же пулы периодически пересоздаются в фоне с jitter, чтобы минимизировать одновременное закрытие и создание кучи соединений.
Но внутри каждого пула остаётся LIFO, а конкретную ноду по-прежнему выбирает L4 только при создании соединения.
Кастомная балансировка на уровне отдельного RPC - на примере gRPC (рис 4)
В http2 привязка к соединению становится ещё важнее: через одно соединение одновременно может идти множество стримов.
Видимо поэтому в gRPC балансировку вынесли в клиент благодаря отдельным моделям: Resolver, который получает адреса доступных нод (аля service discovery), Picker - модель, которую выбирает подходящее соединение (`SubConn`) для каждого запроса.
Клиент может поддерживать соединения сразу с несколькими нодами напрямую, если перед каждым запросом вызывать Picker, который выбирает подходящий SubConn по заданной стратегии - например round-robin или least-request, который тоже использует Power of Two Choices. Но в отличие от clbtransport, здесь выбор происходит уже между конкретными нодами, а не между пулами с агрегированным счётчиком активных запросов на каждый пул.
Не буду пересказывать то о чем можно почитать в
доке gRPC. И подробнее про
реализацию кастомного grpc балансировщика
На этих примерах хорошо видно, что балансировка зависит в том числе от уровня, где она вызывается.
В http.Transport для http 1.x L4 участвует только при создании соединения. Пока keep-alive соединение переиспользуется, новый выбор ноды не происходит - для этого нужно открыть новое соединение.
В gRPC балансировку встроили прямо в клиентскую модель: он поддерживает соединения с несколькими нодами и выбирает подходящее для каждого запроса. Нравится..