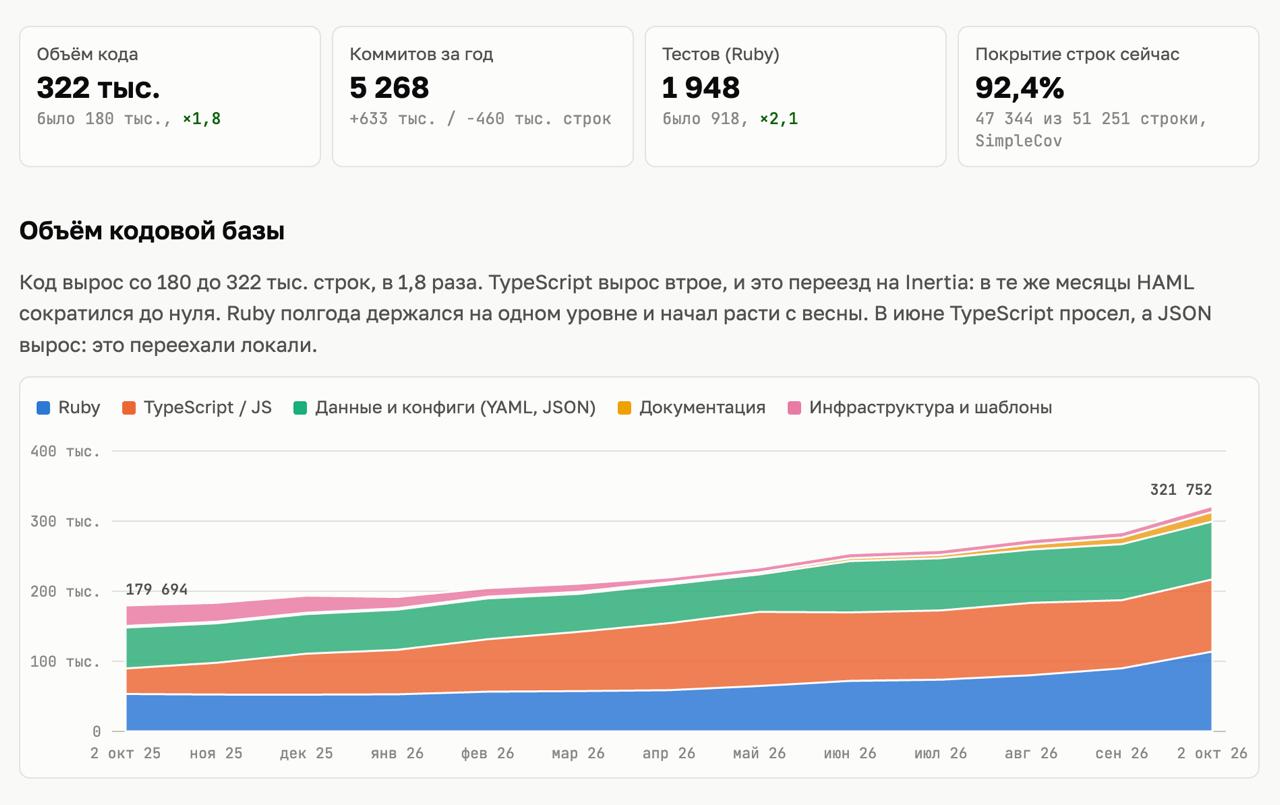
ITПродуктИИhexletразработкаtypescriptrubyииsddСтатистика разработки и внедрения ИИ в HexletО@orgprogавтор про «it»3 недСтатистика по коду Хекслета Раз пошла такая пьянка, давайте я вам выдам еще кучку разной инфы. Про деньги и бизнесовую часть поговорим потом, а щас про коммиты и код. И так погнали. Хекслет не такой маленький проект, как может показаться тем, кто не погружен в нашу кухню. Это по сути lms (learning management system), где много разных биллинговых историй (покупки подписки), управление студентами, кабинет для b2b клиентов, маркетинговые инструменты, управление контентом и большая подсистема запуска и подготовки практик. И это не считая отдельного редактора (по сути ide) и множества других систем делающихся в отдельных репах. В базе порядка 300 таблиц, а про код поговорим ниже. Задач тут много от всех команд, поэтому и изменений тоже много. Активно писать через ИИ мы начали в конце 24 года, но там был долгий этап подготовки, мы типизировали проект, переходили на sdd, делали рефакторинги и всячески адаптировали проект под удобство ии. И вот когда это закончилось (плюс минус), мы рванули фигачить фичи. Поэтому я взял данные за последний год. Учитывайте что это не показывает как было до ии и после ии. Это показывает разгон на фоне улучшения харнеса и перехода в sdd. Итоги года по кодовой базе Hexlet, с октября 2025 по октябрь 2026 Автогенерацию я не считал, только реальный код. В цифрах «было» нет легаси, которое мы за год удалили. Объём кода вырос со 180 до 322 тысяч строк, в 1,8 раза. TypeScript вырос втрое. Ruby полгода стоял на месте, а с весны пошёл вверх. За год мы сделали 5 268 коммитов. Добавили 633 тысячи строк, удалили 460 тысяч. Самым активным месяцем стал сентябрь: 713 коммитов. Сейчас две трети кодовой базы написаны на языках программирования: 114 тысяч строк на Ruby и 103 тысячи на TypeScript. Ещё четверть составляют данные и конфиги: фикстуры, локали, YAML и JSON. По rails stats бэкенд вырос с 20 до 78 тысяч строк кода, а тесты к нему — с 6 до 25 тысяч. Контроллеров было 118, стало 310. Моделей было 122, стало 205. Живых таблиц в базе данных было 149, стало 228. Тестов стало вдвое больше: 1 948 против 918 год назад. Из них 1 536 интеграционных (79%) и 401 юнит-тест (21%), ещё 11 проверяют архитектурные правила. Тестовый код растёт вровень с приложением: на каждые 100 строк кода приходится около 35 строк тестов. Покрытие сейчас 92,4%. Около 60% текущей кодовой базы написано с помощью ИИ. Точно это известно для кода с середины мая: тогда мы начали коммитить через Claude, и с тех пор на ИИ приходится 83% новых строк. Если считать, что до этого доля была такой же, выходит около 60%. По коммитам с явной пометкой получается минимум 38%.hexletразработкаtypescriptrubyииsdd
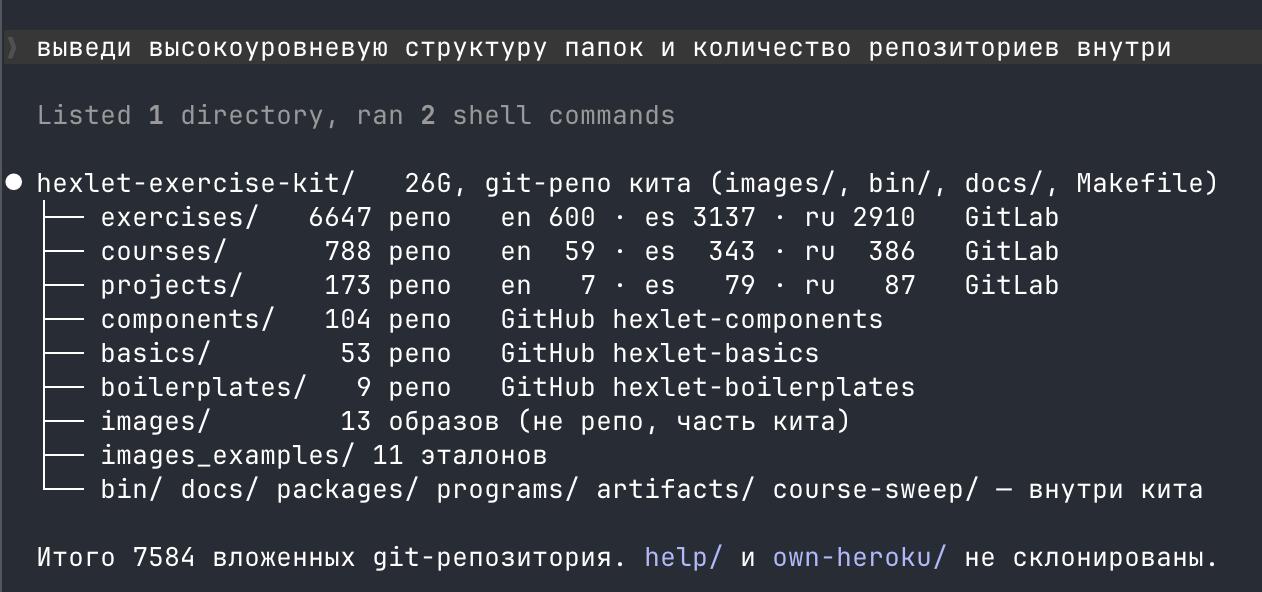
ITИИмонорепозиторийaiразработкаинструментыhexletавтоматизацияЭффективность монорепозиториев для работы с AI-агентамиО@orgprogавтор про «it»2 месВперед к монорепам Практика показывает, что эффективнее всего с агентами работать тогда, когда весь контекст есть по рукой и можно просто погрепать, причем речь идет не про один какой-то конкретный сервис/проект, а когда все репозитории проекта, лежат в одной папке, а возможно даже в одном репозитории. В таком случае и дока общая (это важно для спек) и все просвечивается насквозь и пулреквесты можно сразу бахнуть везде. Но многое зависит от размеров. Понятно что вообще все сервисы в одно место может быть перебором, скорее это правило применимо к командам и тому что у них там внутри. Но это не мешает теоретически заливать и чужие сервисы рядышком, чтобы по ним можно было погрепать если это имеет смысл. Объединения можно добиться двумя способами. Один это тупо все свалить в одну репу (что не заставляет нас собирать все как единый проект) и работать всегда из корня. Более того, в некоторых языках системы сборки поддерживают прямо такой режим работы, поэтому в какой-нибудь Java, получается двойной выигрыш. Второй, это сделать единую высокоуровневую репу, в которой хранятся спеки и любые другие общие доки, а дальше с помощью настроенных команд все клонируется внутрь по подпапочкам. Делать это кстати не обязательно ручками/скриптами, для этого уже есть готовая утилита ghorg. Ну а дальше, эта репа постепенно обрастает артефактами: доками и скриптами, которые помогают работать на всем объеме репозиториев. Если еще на это насадить openspec так вообще красота. Кстати у последнего появилась такая штука как Store, это как раз подобный репозиторий, но без необходимости все складывать внутрь одной папки. Там идея такая что репа со спеками (Store) кладется в домашнюю директорию, а в репах проекта на нее дается ссылка. Дальше команды openspec все это знают учитывают и работают со Store отдельно. И расскажу про наш кейс. На хекслете много практик и проектов. Каждая сущность это своя репа (потому что свой релизный цикл) и даже каждый курс (тексты) это тоже своя репа. Суммарно это под 8000 репозиторев. Плюс для них есть набор базовых образов и разных проверочных скриптов. Так вот у нас всегда существовал подход, когда есть одна базовая репа с общими штуками и туда с помощью make clone добавлялись все эти репы. Но правилось это ручками. А сейчас мало того, что ии может менять все пачками (например связано обновить версию react в курсе + практиках + проекте), так мы еще добавили туда редактор (на него завязана часть логики) и сотни наших реп с гитхаба, куда мы выкладываем разного рода библиотеки и базы данных для курсов. То есть теперь в одном месте практически 100 процентный контекст (осталось еще mcp на хекслете завести, чтобы еще фидбек по курсам и вопросы в ассистента связать). У нас бывают дни, когда мы можем за раз поправить 500-1000 реп.монорепозиторийaiразработкаинструментыhexletавтоматизация