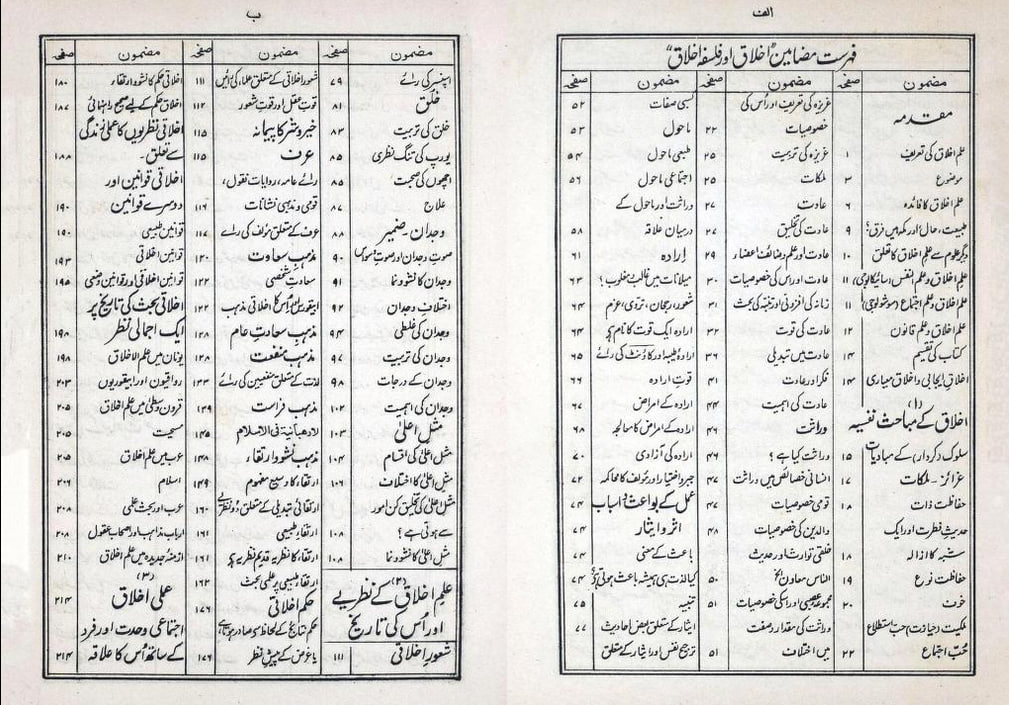
История о том, как надо правильно упарываться по сохранению истории.
Трое товарищей из Пакистана решили в соло оцифровать редчайшие книги и литографии на
урду и запустили проект
Ibteda Digital Library.
Деняг и грантов на такую цель, конечно же им никто не дал, поэтому сканировальную установку собрали из говна и палок: пара бюджетных зеркалок Nikon, светодиодные лампочки и прижимное стекло, выломанное из старого ксерокса.
За 10 лет чуваки выжали из бедных Никонов 902 000 срабатываний затвора и сохранили
около 1800 редких книг.
Когда проект подошёл к концу, на руках осталось
526 000 сфотографированных разворотов, требующих постобработки. Руками в Фотошопе это пришлось бы ковырять до ишачьей пасхи: письменность урду забита точками, палочками и прочими мелкими бесячими закорючками, поэтому шум камеры, грязь, пыль и дефекты старой бумаги легко спутать с настоящим текстом.
Обычные алгоритмы компьютерного зрения ожидаемо обосрались: правила, которые нормально работали на одной книге, полностью ломались на следующей. Тогда один из парней придумал вот чо: взял страницы, которые сам до этого вручную обработал в фотошопе и использовал их как готовую разметку "до/после" для обучения нейронки.
В итоге после обучения получилась небольшая моделька, которой достаточно показать около 10-ти калибровочных страниц новой книги, а остальное она допиливает сама (выравнивает перспективу, режет поля, убирает тени в переплёте и чистит мусор).
Кстати, все оцифрованные книги
залили на Internet Archive. Моё почтение такому DIY.
источник