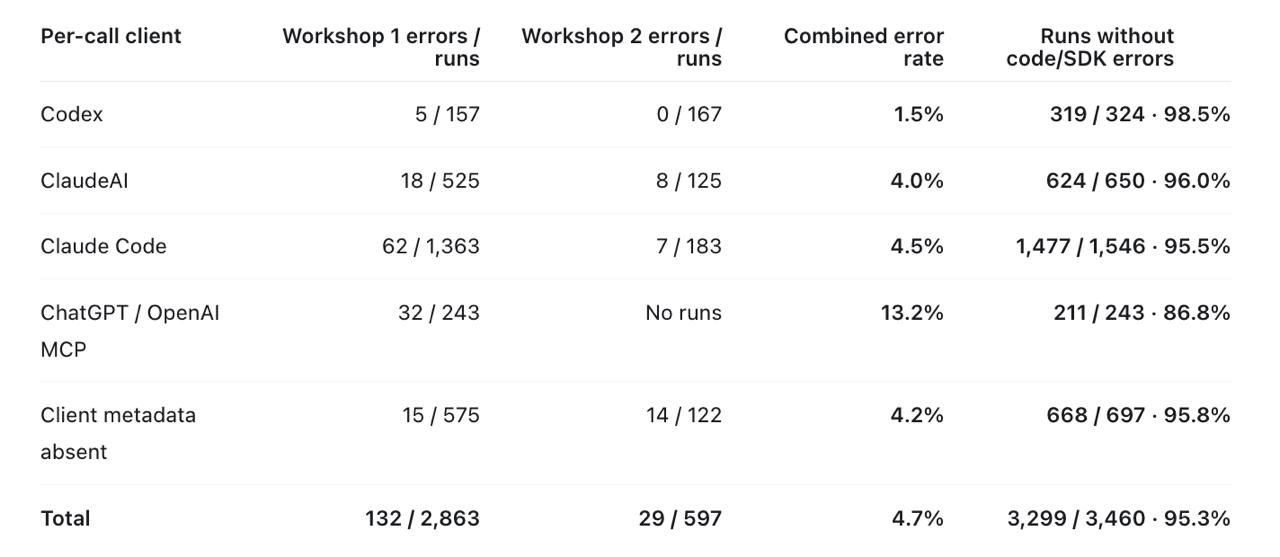
Как разные агенты справляются с незнакомыми инструментами для коллаборации на практике.
Я собрал в кучу данные по тому, как агенты вели себя во
время воркшопов для бизнеса. Среди запросов (которые можно аттрибутировать),
coding агенты (Codex & Claude Code) совершали ошибки при работе с незнакомыми инструментами в 4% запросов, а вот чат агенты (ChatGPT & Claude Chat) - в 6.5% запросов.
В большинстве случаев (94%)
агенты после ошибки сразу исправлялись сами и работали нормально.
У меня есть теория, что пользователи, которые уже гоняют Codex/Claude Code - более продвинуты, им доступны и более мощные модели.
Конкретные данные по моделям мы не записывали, но я сам помогал паре человек подключить к среде бесплатные подписки ChatGPT + Claude Chat. И то, что даже бесплатные подписки могли внести осмысленный вклад в работу группы - радует.
Думаю, можно довести уровень ошибок до ~3% для бесплатных тиров и даже сделать нормальную поддержку для локальных моделей.
Мне хочется дать командам нормальные инструменты для коллаборации, в которые можно воткнуть любых своих агентов.
Ваш, @llm_under_hood 🤗